
适合高频工作
任务会重复、需要读取文件或截图,而且检查规则比较清楚时,优先使用 GLM-5.3-Flash。
Z.AI · 多模态执行模型
GLM-5.3-Flash 是一个速度快、成本较低的 Hermes Agent 模型。它可以读取图片、视频和文件,调用工具,并检查自己的结果。高频重复工作交给它,复杂判断再交给更强的模型。
Hermes 使用时要知道的技术信息
下面这些信息说明 GLM-5.3-Flash 在 Hermes 中适合放在哪一层,以及哪些参数会影响成本和检查方式。
使用边界
让 Agent 开始前先检查
按任务选择模型,不要只看模型名称。
任务会重复、需要读取文件或截图,而且检查规则比较清楚时,优先使用 GLM-5.3-Flash。
系统架构、大型重构、高风险修改和最终审核,更适合交给 GLM-5.3。
高频任务、截图、文件和规则明确的工具任务用 GLM-5.3-Flash。复杂规划、大型重构和最终审核用 GLM-5.3。
适合 Hermes 的任务
同一个 GLM 系列可以承担不同角色。先看任务,再决定由哪个模型执行。
读取截图,完成第一版前端页面,重新渲染,对比结果,再修复明显差异。
从很多文件中提取字段、分类、标记缺失信息,并返回整洁的表格。
调用搜索、文件、浏览器或测试工具,并按照固定格式返回结果。
读取长视频,整理人物和场景,先生成剪辑计划,再交给人工确认。
较低价格适合重复执行。
它可以把看到的内容接到下一步工具动作。
让 Flash 只负责重复步骤和检查。
Hermes 工作流
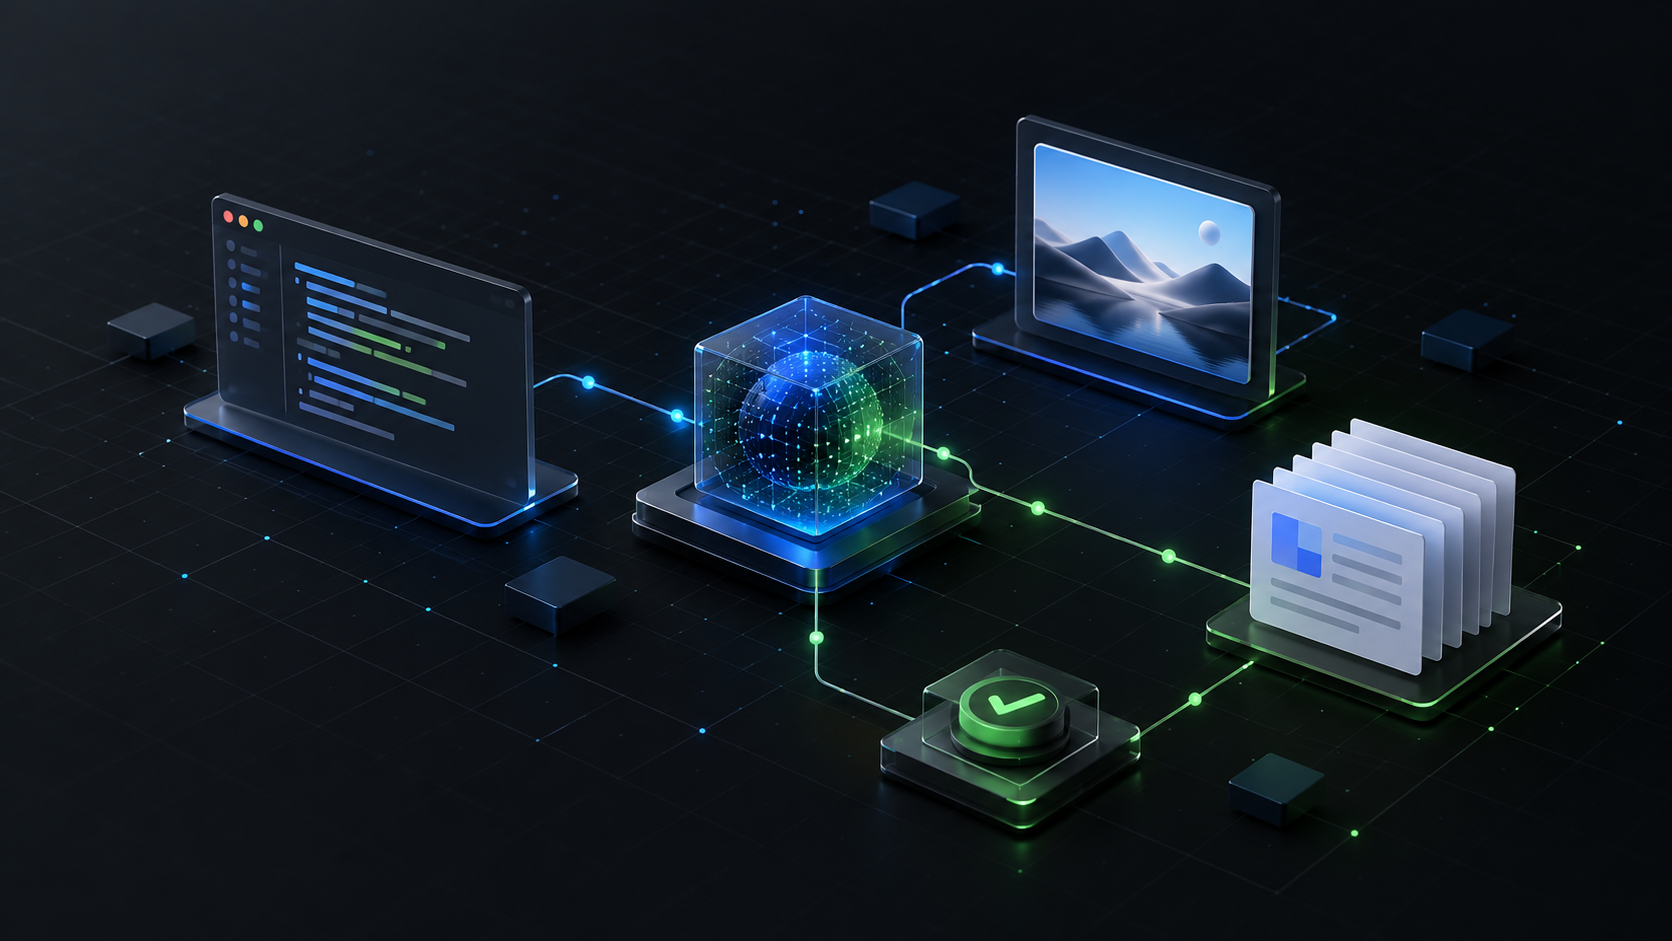
Hermes 保存任务说明、工具权限和审批规则。GLM-5.3-Flash 处理重复步骤,并返回可以检查的结果。
Hermes 把需求整理成文件、动作、检查项和最终交付物。
GLM-5.3-Flash 读取输入,调用允许的工具,并完成修改。
Hermes 要求模型运行测试、生成截图、返回结构化结果并列出不确定项。
只有复杂或高风险判断才交给 GLM-5.3 或人工审核。
实际案例
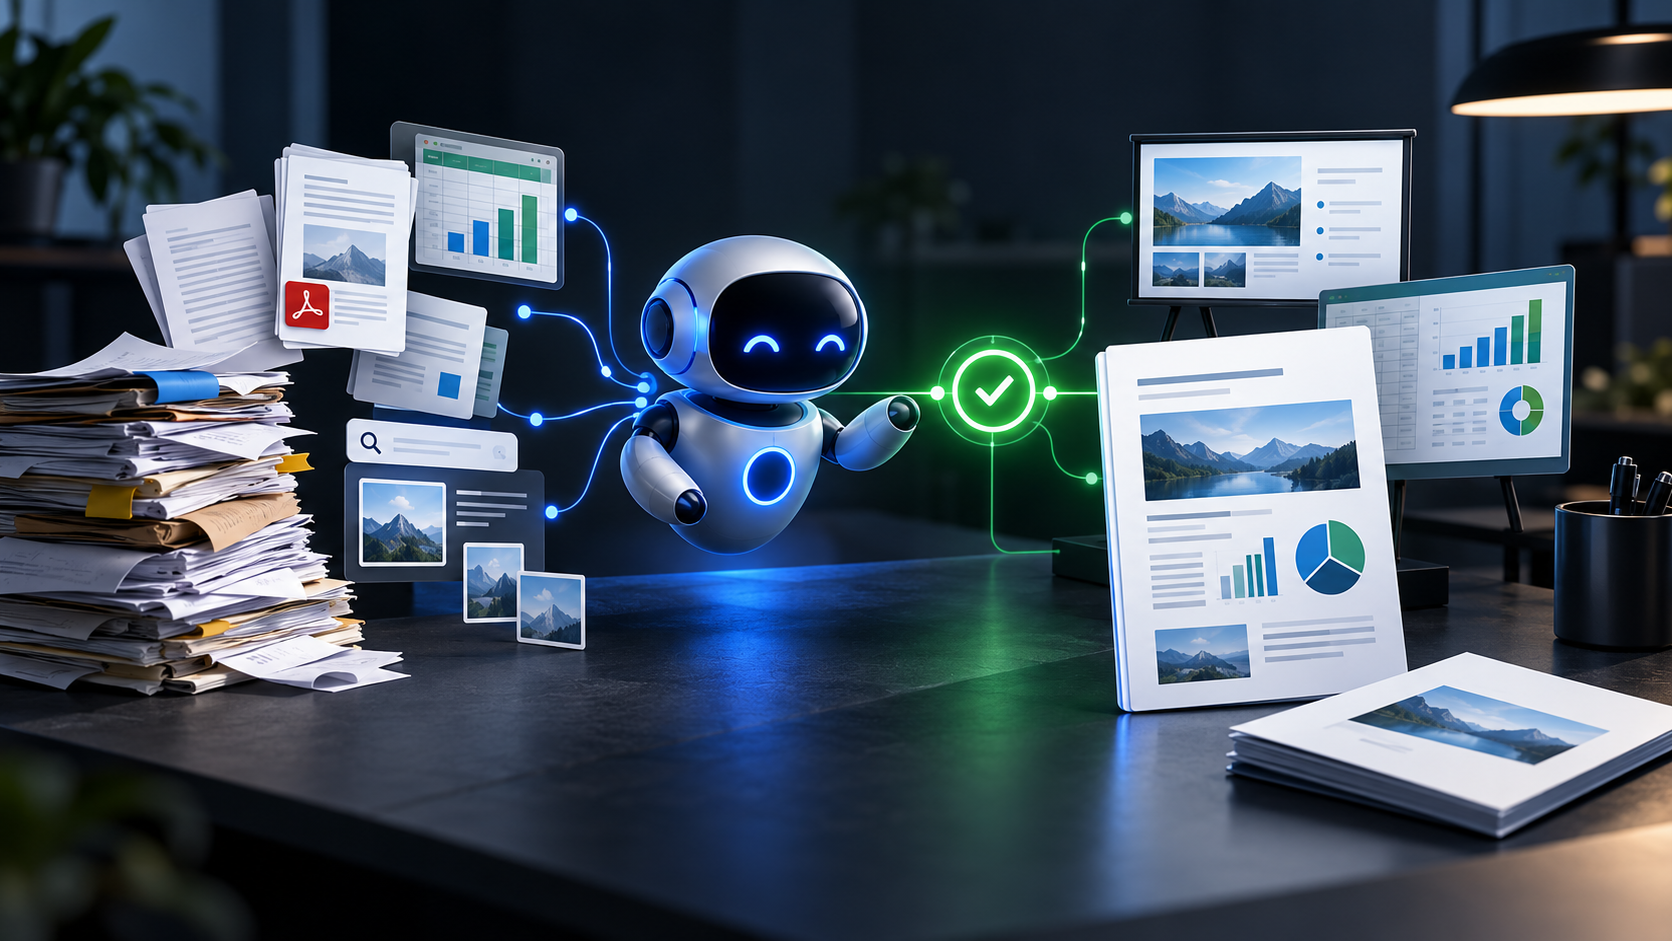
团队把 6 张参考截图和一个现有的 Next.js 项目交给 Hermes。Hermes 先让 GLM-5.3-Flash整理页面结构、重复组件和第一版代码。然后启动本地网站,重新截图,对比间距和图片裁剪,并把修改清单交给模型。经过两轮渲染和检查后,再让 GLM-5.3 审核最终代码。这样,贵的模型只负责架构和审核,不需要处理每一个 CSS 小问题。
Hermes 收到 6 张截图和一个现有的 Next.js 项目。
GLM-5.3-Flash 整理共享组件并生成初版。
Hermes 启动本地网站并截取新图。
模型修正明显差异,GLM-5.3 最后检查架构。
团队把更贵的模型留给架构和审核,而不是让它处理每一个 CSS 小问题。
人工检查登录、支付、生产数据、敏感文件和品牌关键视觉都要人工审核。
成本判断
官方定价中,GLM-5.3-Flash 低于 GLM-5.3。在 Hermes 中,真实成本还取决于输入、输出、工具调用和复核次数。重复工作交给 Flash,影响全局的判断交给更强的模型。
按 Z.AI 当前价格,10 万输入 token 加 2 万输出 token 约为 $0.025,还未计算工具开销。视觉任务可能更大,所以要控制上下文并缓存稳定文件。
在 Hermes 中使用 GLM-5.3-Flash
在 Hermes API 中选择模型,模型 ID 保持为 glm-5.3-flash,并且只开放当前任务需要的工具。
curl https://api.hermes-ai.net/api/v1/chat/completions \
  -H "Authorization: Bearer $HERMES_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "glm-5.3-flash",
    "messages": [{"role":"user","content":"Run the approved task and return a short verification report."}]
  }'
FAQ
它适合高频、重复的执行任务,但社区有人反馈长任务会卡住或循环。要设置时间限制、工具预算和停止条件,复杂判断再交给 GLM-5.3。
可以生成不错的第一版。Hermes 还要重新渲染、对比参考图,把明显差异交回模型继续修复。
截图检查、文件处理和规则明确的工具任务用 Flash;架构、模糊需求和高风险最终审核用 GLM-5.3。
大视觉输入叠加多轮工具调用会让上下文变长。应缩小每轮任务、减少工具数量,并要求 Hermes 定期返回进度。
登录、支付、生产数据、敏感文件和品牌关键视觉内容,都要在发布前人工检查。
HERMES API · GLM-5.3-Flash
在 Hermes API 中选择模型,模型 ID 保持为 glm-5.3-flash,并且只开放当前任务需要的工具。