
如果只看社交媒体,Jev 很容易被误解成“更快、更便宜、还不胡说的 LLM”。这句话听起来痛快,却把它最重要的部分说反了:Jev 的价值不在于更会生成,而在于它根本不把生成文本当作主要任务。
先用一句话说清 Jev
Jev 是 TypeSafe AI 发布的概率化结构决策模型。你把一段文本状态交给它,再提出若干个边界清楚的问题;它返回选项、分数或“是”的概率,而不是一段需要重新解析的自然语言。官方把这个范式概括为:非结构化状态进入,有类型的概率决策出来。
想象一个客服工单。普通聊天模型可能写出:“这位客户看起来有些不满,问题可能与账单有关,建议优先处理。”这段话对人很自然,对程序却很麻烦:到底是不是账单问题?“有些不满”是几级?要不要升级?工程师还得再写解析器、规则和兜底。
同样的输入,Jev 更像是在填写一张事先定义好的判断表:
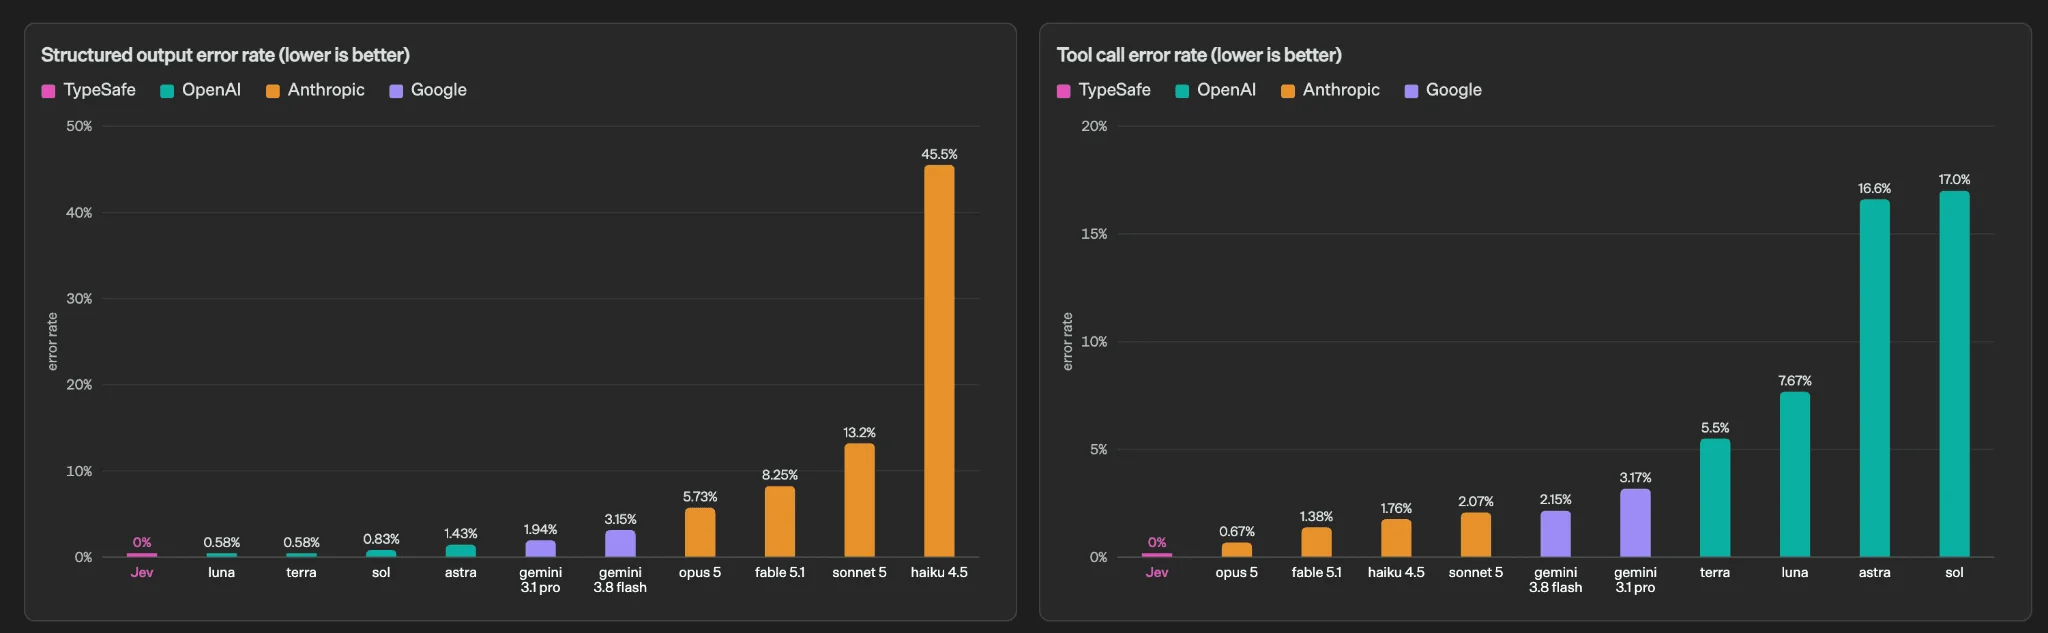
这不是文字风格的差异,而是系统边界的差异。前者把决定藏在句子里,后者把决定变成程序可以直接消费的值。对于每天要做数十万次路由、过滤、排序和安全判断的 Agent 来说,少掉一次“从句子里猜答案”的过程,往往比生成得更聪明更重要。
它从哪里来:System One 不是一句“快思考”的口号
TypeSafe AI 在 2026 年 9 月 15 日正式介绍 Jev,称其为首个公开的 System One Model。这个名字借用了丹尼尔·卡尼曼对“系统一”的通俗描述:快速、直觉、近乎自动地作出判断。模型名称 Jev 则来自 19 世纪经济学家 William Stanley Jevons,以及常被技术行业引用的“杰文斯悖论”——效率提高后,资源总消耗不一定下降,反而可能因为使用变得更便宜而上升。
这层命名多少带着产品宣言:当单次判断便宜到足够低,开发者不只是把原有 LLM 调用替换掉,而会在过去“不值得调用模型”的细小节点上加入判断。邮件是否值得打扰用户、检索结果是否真的相关、网页里哪个按钮最可能继续流程、日志片段是否需要升级给人类,这些任务各自都不宏大,却构成了自动化系统的大部分日常工作。
官方把 Jev 的训练方法称为 RLCD,即 Reinforcement Learning for Calibrated Decisions。公开材料没有披露足以独立复现训练的全部细节,因此不能把这四个字母当作经过同行审查的完整论文结论。我们真正能观察和验证的是产品接口:输出不是自由文本,而是概率分布;模型允许一次针对同一状态并行回答多个独立问题;开发者可以根据风险设置自动执行、人工复核或停止的阈值。
TypeSafe 的联合创始人 Diogo Almeida 曾参与早期 RLHF 与 InstructGPT 工作。这个背景能解释团队为什么对“模型输出怎样进入软件”格外敏感,但履历不是模型效果的替代证据。判断 Jev 是否适合你的业务,最后仍要回到自己的数据、自己的错误成本和自己的阈值上。
Jev 的核心不是 Prompt,而是三种决策原语
第一次读 Jev 文档,最值得慢下来看的不是价格,而是它把问题限制成了什么。当前官方接口主要有三种原语:Choice、Score 和 Noul。它们故意不覆盖所有表达形式,因为限制本身就是可靠性的来源。
Choice:在已知候选中选一个
Choice 用于路由和分类。你提供候选项,例如 refund、billing、technical、other,模型返回被选中的选项、每个候选的概率以及 confidence。官方文档给出的单次候选上限是 255;候选更多时,可以先用 Score 粗筛,再对前若干项做 Choice。
它适合回答“哪个”,不适合偷偷夹带多个标准。比如“选择最紧急、最容易解决、客户价值最高的工单”就把三个目标揉在了一起。更稳的做法是分别询问紧急度、解决难度和客户价值,再由代码计算排序。这种拆法有些笨,却更容易测试,也更容易发现到底是哪一步出了错。
Score:在离散尺度上评分
Score 返回一个预先定义范围内的分数,同时给出各分值的概率分布与 confidence。它可以用来评估相关性、风险、质量、情绪强度或行动优先级。重点是“尺度要可解释”:与其问“这个结果好不好”,不如写清楚 0、5、10 分别代表什么,中间分数如何过渡。
分数看起来比标签精细,也更容易诱发假精确。8 分和 9 分之间是否真的有业务差异?如果没有,就不要让下游逻辑把它们当成两种世界。先决定动作需要多少档,再设计评分尺度,通常比先拿到一个 0—100 的数字、再想它有什么用更可靠。
Noul:只返回“是”的概率
Noul 是最小的判断单元,适合回答“这段内容是否包含个人信息”“用户是否明确要求退款”“这个结果是否满足查询意图”。它返回 0 到 1 之间的概率,不另给一个 confidence 字段。阈值由调用方决定:0.6 可以触发一个无害的界面提示,但涉及封号、付款或删除数据时,0.6 显然远远不够。
三种原语背后有一个很务实的设计选择:模型负责不确定性,代码负责政策。“它有 87% 概率是欺诈”是模型判断;“超过 95% 自动拦截,80%—95% 进入人工队列”是业务政策。把两者分开,团队才能在不重新训练模型的前提下调整风险偏好。
一次调用怎样工作:状态、问题、概率与代码
Jev 的请求体很小:一个 state,一个模型名,以及一组 questions。state 是所有问题共享的事实现场,可以是一封邮件、一个工单、一组搜索结果、一次工具调用轨迹,也可以是经过压缩的网页可访问性树。每个问题独立读取同一份状态,官方服务会并行执行,而不是让第二个问题依赖第一个问题的自然语言回答。
POST https://api.typesafe.ai/v1/systemone

{
  "model": "jev-latest",
  "state": "Customer says the invoice is duplicated and asks for a refund...",
  "questions": [
    {
      "type": "choice",
      "question": "Which team should own this ticket?",
      "options": ["billing", "support", "security", "other"]
    },
    {
      "type": "score",
      "question": "How urgent is this request?",
      "min": 0,
      "max": 10
    },
    {
      "type": "noul",
      "question": "Does the customer explicitly request a refund?"
    }
  ]
}
这种“一份状态,多道原子题”的形式非常适合取代冗长的规则瀑布。它也有一个容易忽略的约束:问题之间相互独立。你不能期待第三问自动知道第一问选了 billing。如果后续问题确实依赖前一步结果,就应分成两次调用,或者先让 Jev 给出多个基础判断,再由代码组合。
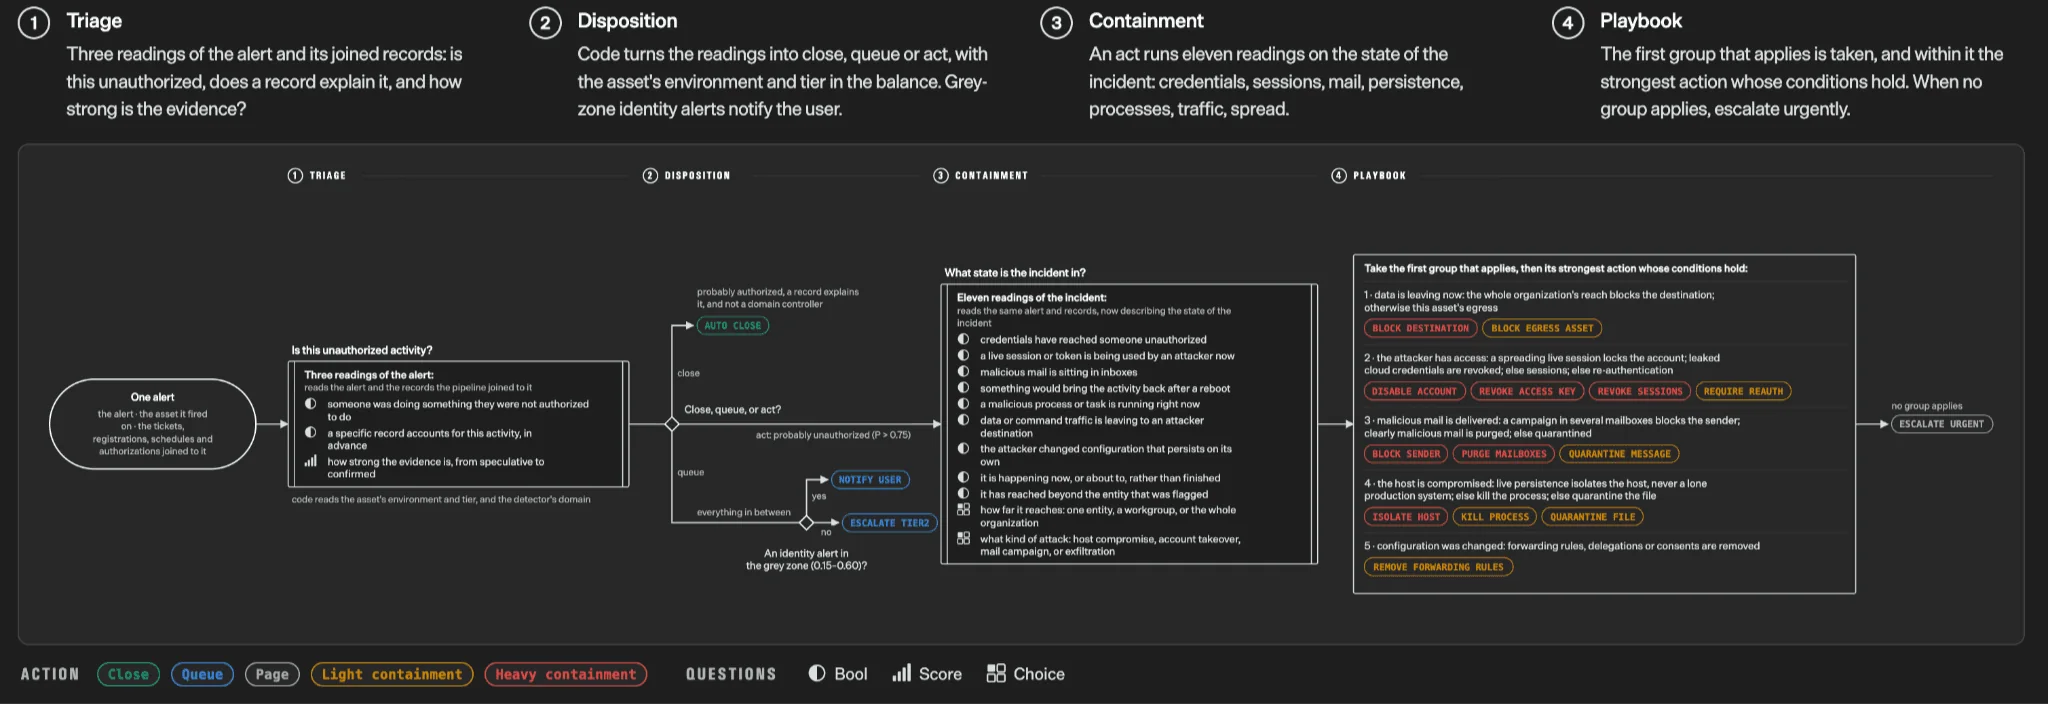
图里最值得借鉴的不是某个安全标签,而是责任分配。复杂工作流没有被塞进一个“万能 Prompt”;模型只做最适合它的模糊判断,布尔关系、阈值、权限和副作用仍由可审计代码控制。这会让系统多几行代码,却少很多无法复现的魔法。
它到底有多快、多便宜?先把三种证据分开
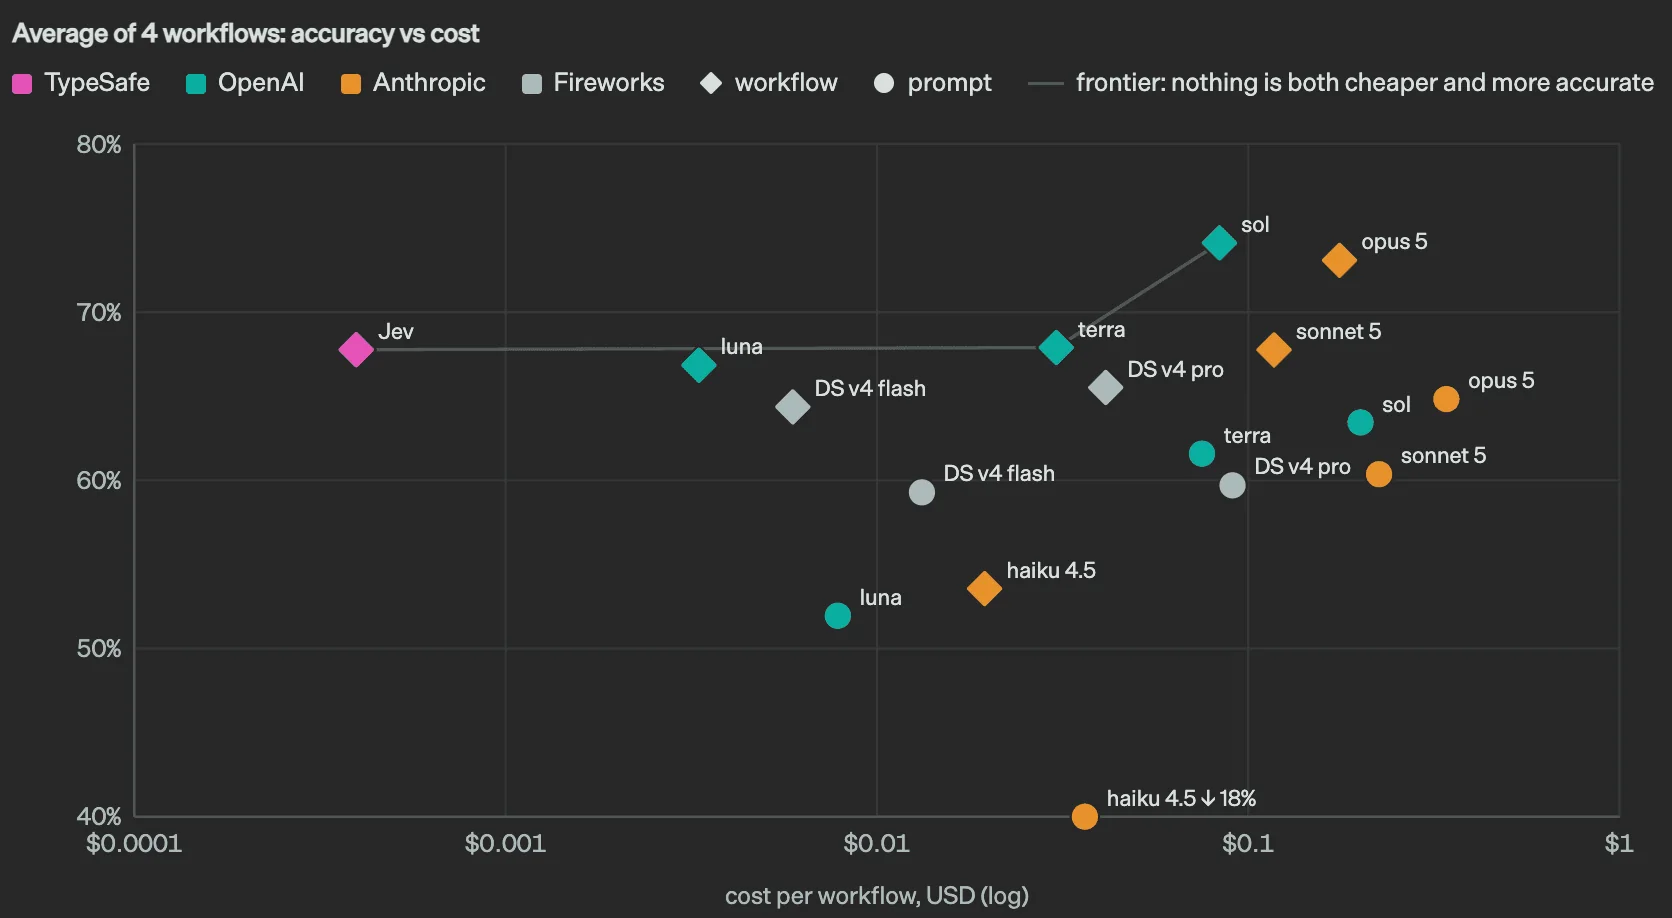
Jev 爆火最直接的原因当然是数字。TypeSafe 当前模型页列出 Jev 1.13 的输入价格为每百万 token 0.042 美元,输出不计费;标称吞吐为每秒 25 万 token、每分钟 1200 次请求。官方发布文章给出的典型延迟区间是 70—500 毫秒,并称在适合 System One 的查询上相对传统推理模型快 40—200 倍。
这些数字很吸引人,但需要分三层读:
- 产品规格:价格、上下文长度、速率限制由服务商直接控制,可以当作当前购买条件,但上线前应再次查看模型页。
- 厂商评测:TypeSafe 在四类内部工作流上报告最高约 193.6 倍速度与 444.6 倍成本优势。官方也坦率注明这是区间上沿,参考标签由 Astra 与 Fable 的结果平均得到,设计可能存在偏向。
- 独立观察:第三方测试更有补充价值,但目前规模、语言和任务范围仍有限,不能把单个结果外推到所有业务。
一项预注册独立测试看到了什么
PrimeLine 设计了三项预注册测试,用四个 Jev 版本跑了两类真实工作,总计约 9750 次 API 调用,花费 0.38 美元。在其中一个汇总为 2600 个样本的测试里,confidence 不低于 0.9 的预测准确率约为 92%,覆盖约 73% 的样本;当 confidence 低于 0.8,结果接近五五开。
这组数据最有价值的地方,并不是“92%”这个漂亮数字,而是它展示了拒答式路由的可行性:高置信样本自动走,低置信样本交给更强模型或人类。但测试同时发现不同原语的校准误差差异很大:报告中的 Noul 约为 0.012、Choice 约为 0.086、Score 约为 0.254。样本并不完全相同,不能机械横比,不过它足以提醒我们:一个总的 confidence 阈值,不一定能覆盖所有问题类型。
一份挪威语早期体验又说明了什么
Emil Lindfors 用 Jev 处理了 24 份挪威语咨询文件。在一个公开案例里,模型没有命中参考标签,但给出的概率本身表现出犹豫;一次包含 11 个问题、约 4995 个输入 token 的调用耗时约 0.31 秒。这个结果很像真实开发现场:速度令人印象深刻,错误却不会因为接口有类型就消失。
还有两点必须写在数字旁边。第一,Jev 1.13 的官方总上下文标为 64k,其中 state 加最长问题的组合上限为 32k;OpenRouter 页面则以 32k context 展示它。不同平台的统计口径可能不同,接入时应以实际端点为准。第二,官方称英文表现最强,中文、日文、韩文等语言可以处理,但稳定性不一。中文团队尤其应该用本地语料单独校准,不能照搬英文阈值。
jev-1.13.0大家到底在用 Jev 做什么?
把公开项目和社交媒体演示放在一起看,会发现热门用法并不是“做一个 Jev 聊天机器人”,而是把它嵌进原本需要大量 Prompt 和小模型调用的决策缝隙。我们整理的 202 个 Jev 公开用例 大致落在下面几类。
1. Agent 路由:决定接下来调用哪个工具
Agent 拿到用户请求后,需要判断是搜索、写代码、查数据库还是向用户追问。过去常用一个小型 LLM 输出 JSON,或者靠关键词规则。Jev 的 Choice 可以直接在工具候选中选择,Score 可以评估是否值得调用昂贵模型,Noul 可以判断当前信息是否足以继续。对高频 Agent 来说,这类路由比最后那段文字更频繁,也更适合用便宜的专用模型承担。
2. 搜索与检索:选数据源、改写查询、重新排序
开源项目 jev-search 展示了一种很克制的组合:Jev 负责选择搜索源、时间范围和查询策略,并对结果做相关性重排,但不生成最终答案。这样的边界很合理,因为搜索系统需要许多小判断,却不一定需要每一步都产出一段话。
3. 浏览器自动化:从页面候选动作中选下一步
浏览器 Agent 经常卡在“页面已经读懂,下一步点哪里”。把可访问性树、按钮文本和当前任务压成 state,再让 Jev 从候选动作中做 Choice,能显著缩短决策时间。这里的关键仍是分工:浏览器工具负责看和点,Jev 负责在文字化候选中选。
Moritz Kremb 把语音转写交给 Jev 做约 300ms 的动作判断,再由浏览器自动化执行点击。视频展示的是整套系统,不是 Jev 单独控制浏览器。
查看原作者帖子 ↗4. 安全与可观测性:给轨迹打标签,而不是重写轨迹
一条 Agent 轨迹可能包含几十次工具调用。你真正想知道的往往是:有没有越权迹象?是否泄露敏感信息?失败来自计划、工具还是环境?让生成模型写一份长评语当然可以,但告警系统最终需要的是标签、分数和是否升级。Jev 的输出形态与这类下游系统天然对齐。
5. 批量内容与商业数据处理
商品归类、评论意图、线索质量、退款原因、发票异常、内容审核,这些任务都有相似结构:输入很多、单条价值不高、错误成本可以分级、输出集合相对稳定。当每天只有一百条数据时,任何模型都能完成;当数量来到百万级,延迟和每 token 成本才真正改变架构。
6. 游戏、机器人与实时交互
TypeSafe 的 Doom 演示经常被误传成“Jev 会看画面玩游戏”。官方说明输入实际上是结构化文字状态,不是像素。Jev 根据血量、弹药、敌人和环境描述选择动作,再由游戏控制层执行。这个区别很重要:它证明的是低延迟决策,而不是视觉理解。类似思路也可用于机器人规划的上层动作选择,但感知、运动控制和安全约束仍需要其他模块。
7. 反例也很有价值:强行用 Choice 生成文字
社区项目 jev-llm 尝试通过反复 Choice 选择下一个 token,让 Jev 像 LLM 一样生成文本。它很有趣,也恰好说明不应该这么用:你可以把螺丝刀当锤子,能敲进去几颗钉子,却丢掉了工具原本的优势。需要写作、总结、解释和代码生成时,直接使用生成模型更合理。
延伸观看:Riley Brown 的 Jev 工作原理与项目演示。视频由第三方作者制作,观点不代表本站或 TypeSafe。
结构化不等于正确:Jev 最容易被吹过头的地方
Jev 的输出不会突然多出一段 Markdown,也不会把本应是数字的字段写成散文。这解决了“格式可靠性”,却没有自动解决“语义正确性”。如果 state 里缺少关键信息、问题含糊、选项互相重叠,模型仍然可能自信地选错。类型系统能保证盒子的形状,不能保证盒子里装的是事实。
TypeSafe 的模型 jaggedness 文档列出的限制相当具体,也比营销页更值得收藏:
- 字面理解:对讽刺、隐含关系、复杂常识和多层间接表达可能不稳。
- 数学与计数:精确算术、计数、金额汇总、日期比较应由代码完成。
- 长状态中的噪声:把整份资料不加筛选地塞进去,会让无关信息稀释关键证据。
- 冲突标准:一道题同时要求“更安全、更便宜、更有创意”,输出很难解释。
- 对抗内容:state 中的提示注入、伪造指令和刻意混淆仍需专门防护。
- 结构关系:它不保证复杂 JSON 树、跨字段约束或数据库不变量成立,这些应由代码验证。
- 开放生成:它本来就不是为长文、摘要、解释、对话和代码生成设计的。
还有一个产品层面的风险:jev-latest 会随着官方升级指向新版本。普通分类任务可以享受自动升级;如果你的自动动作依赖经过严格校准的阈值,应该固定到 jev-1.13.0 之类的明确版本,完成回放测试后再升级。概率从 0.89 变成 0.91 看似很小,却可能跨过生产阈值,改变真实用户会遭遇的动作。
把 Jev 放进生产系统,最稳的方式不是“全量替换”
如果团队已经有一条能工作的 LLM 流程,第一步不该是把所有调用改成 Jev。更好的入口是找出最频繁、输出最短、候选最清楚、错误最容易评估的一个节点。例如:搜索结果是否相关、工单属于哪个队列、某次工具调用是否异常。挑一万个历史样本回放,比围绕几个演示视频争论更快。
建立三段式决策通道
可以从一个保守的阈值策略开始:
- 高置信、低风险:直接执行,例如给内部文档加标签。
- 中等置信:转交更强的生成模型,或者补充检索后再次判断。
- 低置信或高风险:进入人工队列,不让系统假装自己知道。
阈值不能从别人的博客复制。你需要分别计算准确率、覆盖率、误报成本和漏报成本。内容推荐的误报可能只是一次糟糕点击;安全拦截的误报可能让用户无法工作。即使是同一个 Noul 概率,两个场景也应该有完全不同的动作政策。
保留完整的决策记录
生产日志至少要保存模型版本、问题版本、state 的可追溯引用、候选项、完整概率分布、最终阈值以及实际执行动作。只记住最后的 billing,会丢掉最有价值的信息:当时 billing 是 0.91 对 0.05,还是 0.36 对 0.34?前者像明确决定,后者只是勉强第一。
把确定性工作留给代码
金额相加、日期比较、权限检查、状态机合法性、唯一性约束,这些都不需要神经网络。Jev 应放在规则无法轻易写出的模糊边界上,而不是接管已经能被代码精确完成的工作。一个成熟的 Jev 系统看起来通常并不“全 AI”:它有检索、有数据清洗、有模型判断,也有大量朴素的 if、枚举和校验器。
警惕状态变长带来的隐形退化
模型便宜后,团队很容易把更多上下文塞进去。可读 token 成本下降,不代表注意力是免费的。把 200 个搜索结果全交给模型,不如先用硬条件过滤到 30 个;把整份网页 DOM 交进去,不如保留可见控件、标签和附近文字。Jev 的速度优势会鼓励更多调用,而好的预处理决定这些调用有没有意义。
如何开始:先在 Playground 里把问题问对
最短路径是打开 TypeSafe Playground,拿十几条真实样本试三个原语。不要先追求一个覆盖所有情况的大 Prompt。先写一个问题,观察概率分布,再故意放入边界样本:信息缺失、候选重叠、反讽表达、长噪声、中文口语、错别字。你想知道的不是它在标准样本上有多漂亮,而是它在什么地方开始犹豫。
正式接入可以直接调用 https://api.typesafe.ai/v1/systemone,模型名用 jev-latest 或固定版本。官方也提供 Python SDK:
pip install typesafe-sdk如果你使用 Codex、Claude Code 或其他支持 skills 的 Agent,TypeSafe 维护了一个官方 skill,可以用下面的命令安装:
npx skills add typesafe-ai/skills --skill typesafe-aiskill 的意义不是让 Jev 神奇地接管 Agent,而是给 Agent 一份可复用的调用说明:遇到分类、评分、二元判断时,知道怎样组织 state、怎样选择原语、怎样读取结果。是否真的调用、把哪些数据发给服务商、阈值怎样设置,仍由你的工程和安全政策决定。
如果你只是想找灵感,可以继续浏览本站的 Jev 用例库。里面收录了 202 条公开案例,包含作者和原帖链接。先看别人把 Jev 放在哪个“决策缝隙”里,再回头找自己产品中同样狭窄、重复、昂贵的节点,通常比从“我要做一个 Jev 应用”出发更容易得到好答案。
关于 Jev 的常见问题
Jev 是大语言模型吗?
它使用神经网络理解文本,但产品形态与聊天式大语言模型不同。Jev 不负责续写文章,而是针对你提供的状态与问题,返回 Choice、Score 或 Noul 等有约束的概率化判断。
Jev 能直接操作浏览器吗?
不能。Jev 可以根据页面状态判断应该点击哪个候选项,但读取网页、截图、点击、输入和等待页面加载,仍要由浏览器自动化工具或 Agent 框架执行。
Jev 支持图片、音频和视频吗?
Jev 1.13 是纯文本模型。图片、音频与视频需要先经过 OCR、语音转写、目标检测或其他多模态模型,转换为清晰的文本状态后再交给 Jev。
Jev 的 confidence 可以直接当准确率吗?
不应直接等同。confidence 是模型对当前分布集中程度的表达,是否校准仍取决于任务、问题写法、语言和数据分布。上线前应在自己的样本上画覆盖率与准确率曲线,再确定自动执行阈值。
Jev 适合替代所有 LLM 调用吗?
不适合。它擅长高频、原子、可枚举的判断;写邮件、总结长文、解释理由、生成代码等开放式任务仍应交给生成模型。好的系统往往让 Jev 决定“做什么”,让代码或生成模型负责“怎么做”。
如何在 Codex 或其他 Agent 中使用 Jev?
可以直接调用 TypeSafe API,也可以安装 TypeSafe 官方 agent skill,让 Agent 知道何时把分类、评分和二元判断交给 Jev。关键不是多装一个工具,而是把决策拆成原子问题并在代码中保留最终控制权。
最后的判断:Jev 值得关注,但别把它变成宗教
Jev 最有意思的地方,不是它会不会取代某个大模型,而是它让一个长期被忽略的问题重新变得清楚:软件里的很多 AI 调用,本来就不需要生成一段话。我们只是因为手里只有会续写文字的模型,才把分类、评分、路由、审查和开关都伪装成了聊天。
当模型原生返回概率化的类型值,工程师终于可以更自然地讨论覆盖率、阈值、升级路径和错误成本。这不是“没有幻觉”的魔法,也不是通用智能的捷径;它更像一块专门为决策层切出的芯片。放对位置,速度和价格会改变产品能够承受的判断密度。放错位置,它也会像任何热门工具一样,变成一层新包装。
所以真正值得做的实验很简单:选一个低风险、高频、已有历史标签的决策点,用固定版本跑回放;把高置信样本自动化,把不确定性公开留给下一层;一个月后再看成本、延迟与错误是否真的下降。Jev 的价值不该由转发量证明,而应由那些悄悄消失的解析器、超时和人工队列证明。
资料来源与阅读说明
我们优先引用官方文档确认接口、版本和限制;性能数字若来自 TypeSafe 自测,会明确标为厂商评测。第三方测试用于交叉验证,但不把单次实验包装成普遍结论。访问日期:2026 年 9 月 20 日。
- TypeSafe:Introducing System One Models and Jev(官方发布、架构与自有评测)
- TypeSafe Docs:Introduction(Choice、Score、Noul 与并行问题)
- TypeSafe Docs:Models(Jev 1.13 规格、价格、多语言与数据政策)
- TypeSafe Docs:Jev 1.13 Jaggedness(已知限制)
- TypeSafe Docs:Confidence(置信度解释与风险路由)
- TypeSafe Workflow Evals(四类官方工作流评测)
- PrimeLine:A Pre-Registered Test of TypeSafe Jev(独立预注册测试)
- Emil Lindfors:A First Look at TypeSafe's Jev(挪威语早期测试)
- DataCamp:System One Models and Jev(第三方概览与基准提醒)
- Awesome Jev / TypeSafe(社区项目索引)