
En redes sociales, Jev suele presentarse como «un LLM más rápido, más barato y que no alucina». La frase es pegadiza, pero invierte lo esencial: su valor no está en redactar mejor; su tarea principal ni siquiera es generar texto.
Jev en una frase
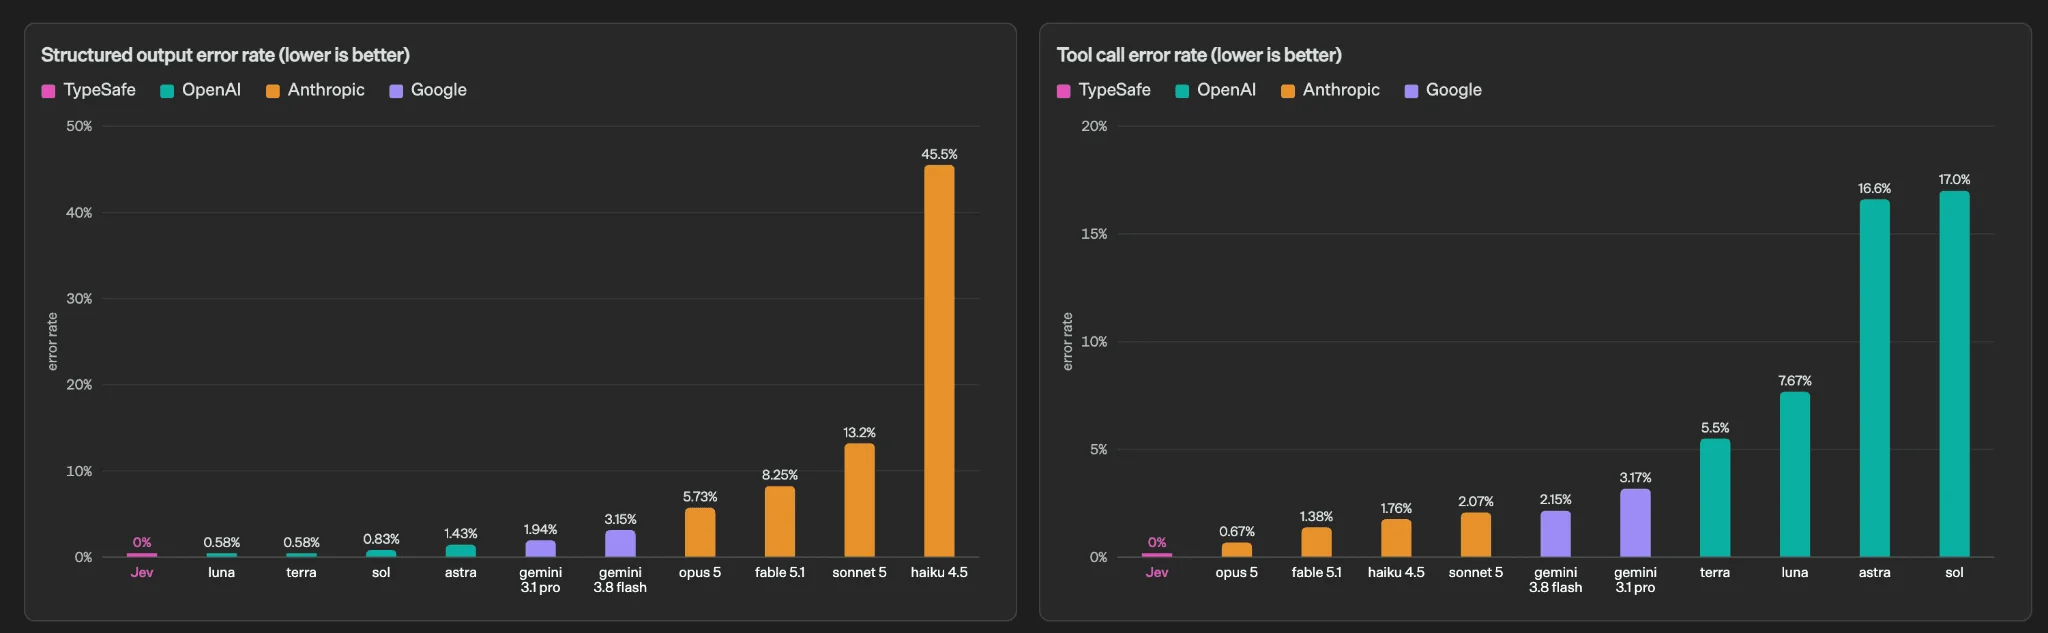
Jev es el modelo de decisión estructurada y probabilística de TypeSafe AI. Se le entrega un estado textual y varias preguntas bien delimitadas. Devuelve una opción, una puntuación o la probabilidad de que la respuesta sea «sí», en lugar de un párrafo que la aplicación tenga que volver a interpretar. TypeSafe resume el enfoque así: entra un estado no estructurado y salen decisiones probabilísticas tipadas.
Imagina un ticket de soporte. Un modelo conversacional podría responder: «El cliente parece molesto; quizá sea un problema de facturación y convendría atenderlo pronto». Suena natural, pero el programa todavía necesita averiguar si realmente es un asunto de facturación, qué significa «molesto» y si debe escalarlo. Al final hacen falta analizadores, reglas y alternativas de reserva.
Jev rellena una ficha de decisión que la aplicación ya ha definido:
No es una diferencia de estilo, sino de arquitectura. Un modelo esconde la decisión dentro de una frase; el otro la expresa como un valor que el software puede consumir. En un agente que enruta, filtra, ordena y evalúa seguridad cientos de miles de veces al día, quitar el paso de «adivinar la respuesta a partir del texto» puede importar más que redactar la respuesta final con más ingenio.
Aclara primero sus límites. Jev no controla navegadores ni analiza imágenes. Ego, Playwright u otra herramienta de agentes se encarga de cargar páginas, leer capturas, hacer clic y escribir. Jev puede elegir una acción a partir del estado textual que preparen esas herramientas. Jev 1.13 solo admite texto: no ve imágenes ni interpreta audio o vídeo directamente.
De dónde viene: «System One» es más que un lema sobre velocidad
TypeSafe AI presentó Jev el 15 de septiembre de 2026 como el primer System One Model disponible públicamente. El nombre alude a la descripción popular de Daniel Kahneman del pensamiento del Sistema 1: rápido, intuitivo y casi automático. «Jev» remite al economista del siglo XIX William Stanley Jevons y a la paradoja de Jevons: mejorar la eficiencia no siempre reduce el consumo total; al abaratar el uso, a veces aumenta.
El nombre también expresa una tesis de producto. Cuando una decisión cuesta muy poco, los desarrolladores no solo sustituyen una llamada a un LLM: pueden incorporar juicios del modelo en puntos donde antes no compensaba llamarlo. ¿Merece este correo interrumpir a alguien? ¿Es relevante este resultado? ¿Qué botón acercará más al usuario a completar la tarea? ¿Hay que escalar este fragmento de registro a una persona?
TypeSafe denomina RLCD a su método de entrenamiento: Reinforcement Learning for Calibrated Decisions. La información pública no basta para reproducir el entrenamiento de forma independiente, así que el nombre no equivale a una descripción científica revisada por pares. Lo observable es la interfaz: distribuciones de probabilidad en lugar de texto libre, varias preguntas independientes sobre un mismo estado y umbrales que cada equipo puede fijar para automatizar, revisar o detenerse.
Diogo Almeida, cofundador de TypeSafe, participó en trabajos tempranos sobre RLHF e InstructGPT. Ese recorrido ayuda a entender el interés del equipo por cómo entran las respuestas de un modelo en el software, pero una trayectoria profesional no demuestra la calidad del modelo. Para saber si Jev encaja, hay que medirlo con los datos, los costes de error y los umbrales de cada producto.
El núcleo no es el prompt: son tres primitivas de decisión
Al leer la documentación de Jev, conviene fijarse menos en el precio y más en cómo limita cada pregunta. La interfaz principal ofrece tres primitivas: Choice, Score y Noul. No abarcan todas las formas de expresión; esa restricción es parte de lo que hace más controlable el resultado.
Choice: elegir entre candidatos conocidos
Choice sirve para enrutar y clasificar. Se proporcionan opciones, por ejemplo refund, billing, technical y other; el resultado incluye la elegida, la probabilidad de cada candidata y un valor de confidence. La documentación fija en 255 el máximo de opciones por pregunta. Si hay más, se puede usar Score para reducir la lista y luego aplicar Choice a las finalistas.
Choice responde «¿cuál?», pero no debería mezclar criterios sin decirlo. «Elige el ticket más urgente, más fácil de resolver y de mayor valor» combina tres objetivos. Es más claro preguntar por urgencia, dificultad y valor por separado, y dejar que el código calcule el orden. Parece menos sofisticado, pero facilita las pruebas y el diagnóstico.
Score: puntuar dentro de una escala discreta
Score devuelve un valor dentro del rango definido, junto con una distribución de probabilidad entre puntuaciones y confidence. Puede estimar relevancia, riesgo, calidad, intensidad emocional o prioridad. La escala debe tener un significado claro: especifica qué representan 0, 5 y 10, y qué cambia entre ellos, en vez de preguntar si algo es «bueno».
Una cifra parece más precisa que una etiqueta, pero también puede dar una falsa sensación de exactitud. ¿De verdad cambia una decisión de negocio entre 8 y 9? Si no, el sistema no debería tratarlos como mundos distintos. Primero define cuántas acciones necesitas; después diseña la escala.
Noul: devolver la probabilidad de «sí»
Noul es la unidad más pequeña. Sirve para preguntar si un texto contiene datos personales, si alguien ha solicitado claramente un reembolso o si un resultado responde a una intención. Devuelve una probabilidad entre 0 y 1, sin un campo separado de confidence. Quien integra el modelo fija el umbral: 0,6 quizá baste para mostrar un aviso inocuo, pero no para suspender una cuenta, cobrar dinero o borrar datos.
La separación práctica es sencilla: el modelo se ocupa de la incertidumbre; el código, de la política. «Hay un 87 % de probabilidad de fraude» es un juicio del modelo. «Bloquear automáticamente por encima del 95 % y enviar de 80 % a 95 % a revisión humana» es una política de negocio. Mantenerlos separados permite ajustar el riesgo sin volver a entrenar el modelo.
Cómo funciona una llamada: estado, preguntas, probabilidades y código
La petición tiene un state compartido, el nombre del modelo y varias questions. El estado reúne la evidencia que consultarán todas las preguntas: un correo, un ticket, resultados de búsqueda, la secuencia de herramientas o un árbol de accesibilidad resumido. Cada pregunta se evalúa de forma independiente sobre ese mismo estado; la siguiente no hereda automáticamente la respuesta anterior.
POST https://api.typesafe.ai/v1/systemone

{
  "model": "jev-latest",
  "state": "Customer says the invoice is duplicated and asks for a refund...",
  "questions": [
    { "type": "choice", "question": "Which team owns this ticket?", "options": ["billing", "support", "security", "other"] },
    { "type": "score", "question": "How urgent is this request?", "min": 0, "max": 10 },
    { "type": "noul", "question": "Does the customer explicitly request a refund?" }
  ]
}
Este formato puede sustituir una larga cascada de reglas, pero hay que recordar que las preguntas son independientes. Si la tercera depende de la respuesta de la primera, sepáralas en varias llamadas o pide a Jev los juicios básicos y combínalos en código.
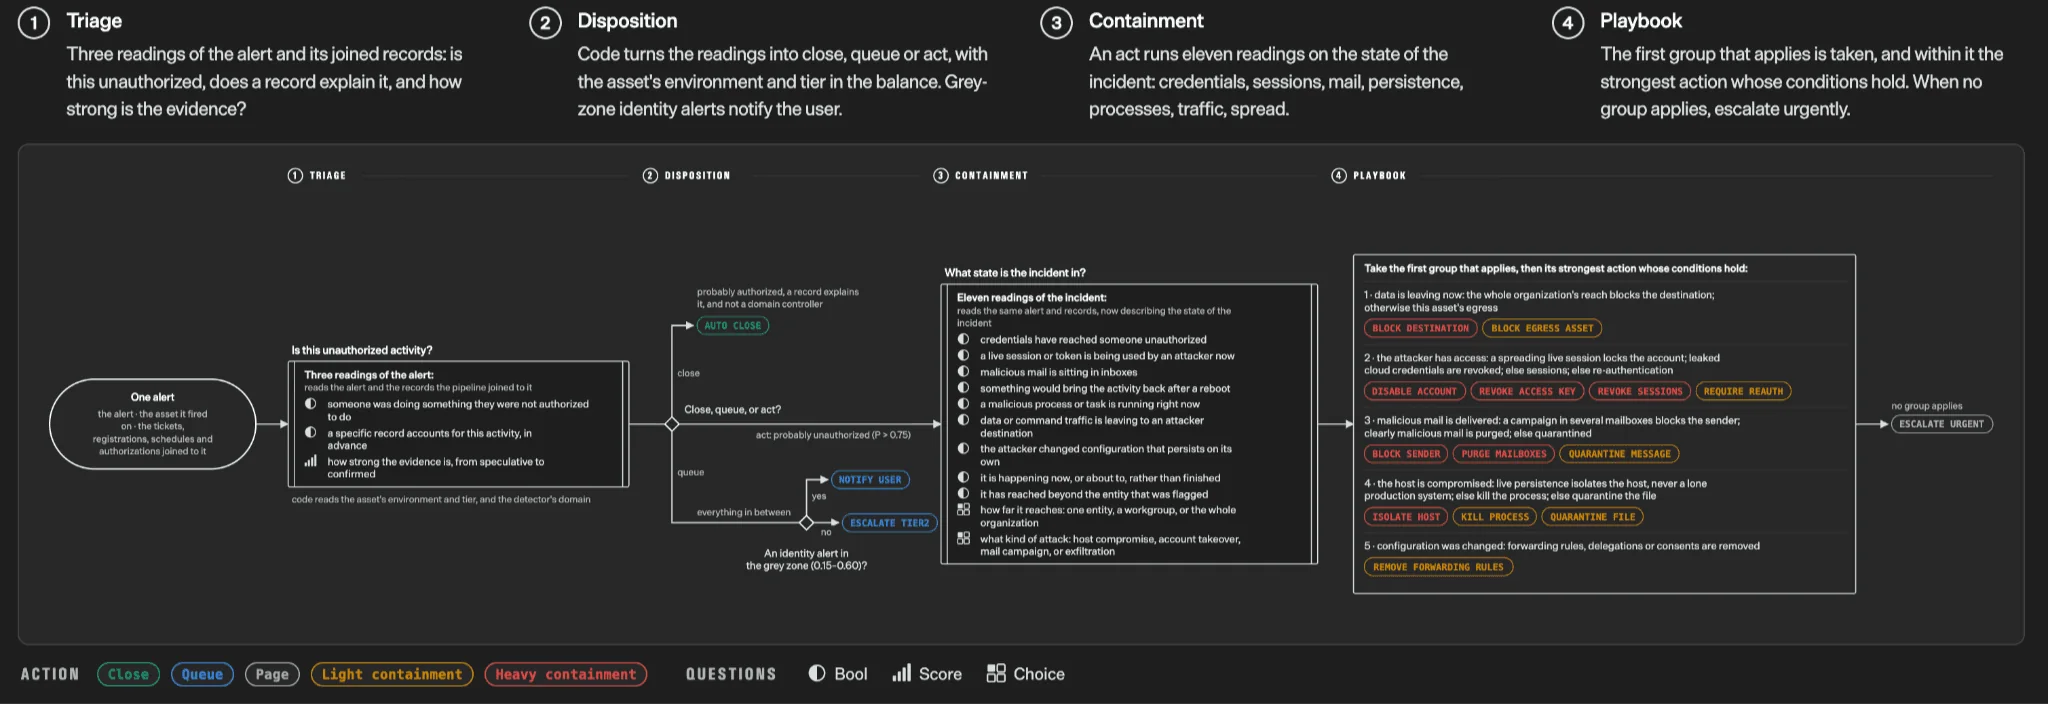
La idea valiosa es repartir responsabilidades. No se mete todo en un «prompt mágico»: Jev resuelve los juicios ambiguos que se le dan bien; la lógica booleana, los umbrales, los permisos y los efectos secundarios siguen en código auditable.
¿Cuánto cuesta y qué tan rápido es? Separa tres tipos de evidencia
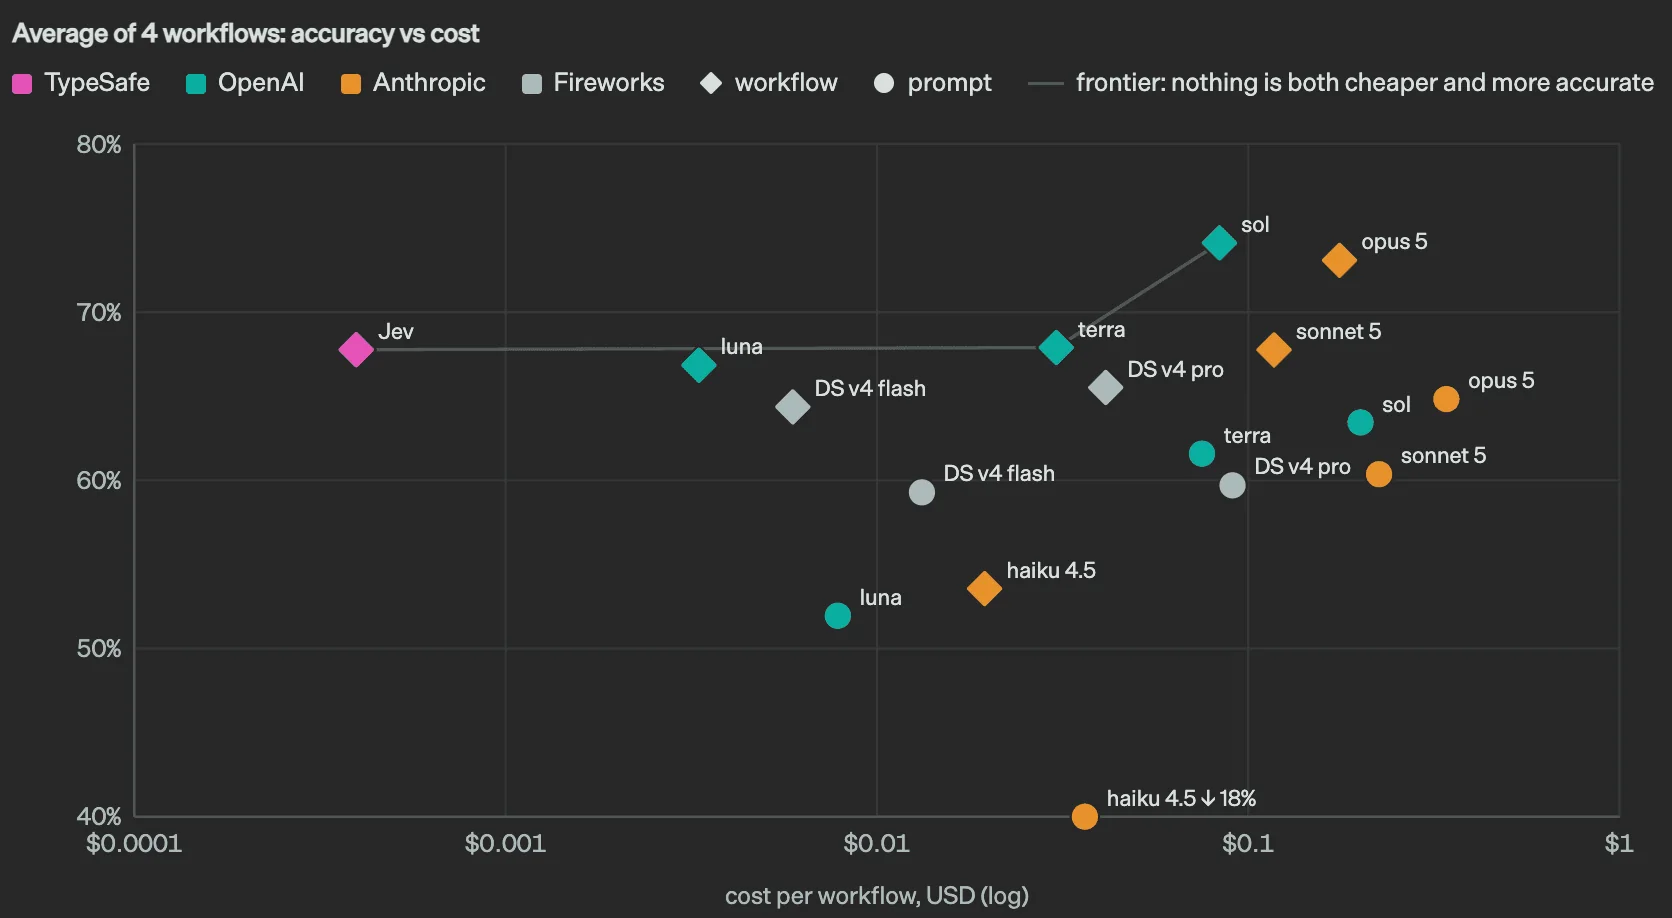
Las cifras explican parte de la repercusión de Jev. En la ficha del proveedor, Jev 1.13 aparece con un precio de 0,042 USD por millón de tokens de entrada y sin coste de salida; anuncia hasta 250.000 tokens por segundo y 1.200 solicitudes por minuto. El artículo de lanzamiento indica una latencia habitual de 70–500 ms y afirma que, en tareas adecuadas para System One, puede ser entre 40 y 200 veces más rápido que modelos de razonamiento tradicionales.
Conviene leer esos datos en tres niveles:
- Especificaciones del producto: precio, contexto y límites de uso son condiciones comerciales que controla el proveedor. Compruébalas de nuevo antes de poner el servicio en producción.
- Evaluaciones del proveedor: TypeSafe comunica ventajas de hasta aproximadamente 193,6× en velocidad y 444,6× en coste en cuatro flujos internos. La empresa las presenta como valores máximos y explica que las etiquetas de referencia promedian las salidas de Astra y Fable, un diseño que puede favorecer su método.
- Observaciones independientes: aportan otro punto de vista, pero las pruebas disponibles cubren pocas tareas, idiomas y muestras. Un resultado aislado no se puede extrapolar a cualquier negocio.
Qué encontró una prueba independiente prerregistrada
PrimeLine diseñó tres pruebas prerregistradas y evaluó cuatro versiones de Jev en dos tareas reales: unas 9.750 llamadas a la API, con un coste de 0,38 USD. En una prueba resumida con 2.600 ejemplos, las predicciones con confidence de al menos 0,9 acertaron alrededor del 92 % y cubrieron cerca del 73 % de la muestra. Por debajo de 0,8, los resultados se acercaron al azar.
Lo interesante no es el llamativo «92 %», sino el patrón de abstención: automatizar los casos de confianza alta y derivar los dudosos a un modelo más capaz o a una persona. El informe también encontró errores de calibración distintos según la primitiva: aproximadamente 0,012 para Noul, 0,086 para Choice y 0,254 para Score. Las muestras no son totalmente comparables, pero muestran por qué un solo umbral de confidence puede no servir para todas las preguntas.
Qué aporta una prueba temprana en noruego
Emil Lindfors probó Jev con 24 documentos de consulta en noruego. En un ejemplo público, el modelo no acertó la etiqueta de referencia, aunque la distribución mostraba dudas. Una llamada con 11 preguntas y unos 4.995 tokens de entrada tardó alrededor de 0,31 segundos. Es una experiencia de desarrollo bastante realista: latencia llamativa, y un error que no desaparece porque la interfaz tenga tipos.
Hay dos matices sobre el contexto. TypeSafe publica un contexto total de 64k para Jev 1.13 y un límite combinado de 32k para el estado más la pregunta más larga; OpenRouter muestra un contexto de 32k. Cada proveedor puede contar de forma distinta, así que verifica el endpoint concreto. TypeSafe también indica que el inglés es el idioma más sólido. El chino, japonés, coreano y otros idiomas pueden funcionar con estabilidad desigual: calibra los umbrales con tus propios datos y en el idioma que usarás.
Qué se está construyendo con Jev
En proyectos y demostraciones públicas, el patrón no suele ser «crear un chatbot con Jev», sino insertar el modelo en decisiones pequeñas que antes exigían muchos prompts, llamadas a modelos pequeños o reglas frágiles. El directorio de casos de uso de Jev reúne 202 ejemplos públicos.
1. Enrutamiento de agentes: elegir la siguiente herramienta
Un agente puede tener que buscar, escribir código, consultar una base de datos o pedir una aclaración. Es habitual usar un LLM pequeño que devuelva JSON o reglas basadas en palabras clave. Choice puede seleccionar una herramienta; Score puede estimar si merece la pena llamar a un modelo más caro; Noul puede determinar si ya hay información suficiente para continuar. En agentes de alto volumen, el enrutamiento puede ocurrir más veces que la respuesta final.
2. Búsqueda y recuperación: elegir fuentes y reordenar resultados
El proyecto de código abierto jev-search adopta un enfoque comedido: Jev elige la fuente, el intervalo temporal y la estrategia de búsqueda, y vuelve a ordenar los resultados por relevancia sin redactar la respuesta. Un buscador necesita muchos juicios pequeños, no necesariamente un párrafo en cada paso.
3. Automatización del navegador: elegir entre acciones posibles
Un agente de navegador suele llegar a un punto en que entiende la página, pero no sabe qué pulsar. Se puede resumir el árbol de accesibilidad, los nombres de botones y la tarea en un estado textual, y pedir a Jev que elija una acción. El navegador sigue leyendo y ejecutando el clic; Jev solo escoge entre opciones descritas en texto.
4. Seguridad y observabilidad: etiquetar una secuencia
Una secuencia de un agente puede incluir decenas de llamadas a herramientas. Interesa saber si intentó saltarse permisos, expuso datos sensibles o falló por el plan, la herramienta o el entorno. Los sistemas de alertas necesitan etiquetas, puntuaciones y decisiones de escalado; la salida de Jev encaja mejor ahí que una evaluación extensa generada en prosa.
5. Procesamiento por lotes de contenido y datos de negocio
Clasificar productos, detectar intención en reseñas, puntuar oportunidades comerciales, identificar motivos de reembolso, anomalías en facturas y contenido que moderar tienen una estructura común: muchas entradas, valor limitado por elemento, costes de error graduables y un conjunto de resultados relativamente estable. Con cien registros al día, casi cualquier modelo puede servir; con un millón, la latencia y el coste por token sí pueden cambiar la arquitectura.
6. Juegos, robótica e interacción en tiempo real
La demostración de Doom de TypeSafe a veces se resume como «Jev ve la pantalla y juega». Según la explicación del proveedor, la entrada es un estado textual estructurado, no píxeles. Jev elige una acción a partir de una descripción de salud, munición, enemigos y entorno; la capa de control del juego la ejecuta. Eso demuestra decisiones de baja latencia, no comprensión visual. En robótica puede usarse algo parecido para elegir acciones de alto nivel, pero la percepción, el control motor y la seguridad siguen siendo responsabilidad de otros módulos.
7. Un contraejemplo útil: generar texto con Choice
El proyecto comunitario jev-llm experimenta con elegir repetidamente el siguiente token para que Jev genere texto. Es interesante, en parte, porque muestra qué conviene no optimizar. Se puede clavar un clavo con un destornillador, pero no por eso es la herramienta adecuada. Para redactar, resumir, explicar o generar código, es mejor usar un modelo generativo.
Una salida estructurada no significa que sea correcta
Jev no devuelve Markdown cuando se esperaba un número. Eso mejora la fiabilidad del formato, pero no garantiza que el significado sea correcto. Si faltan datos en el estado, la pregunta es ambigua o las opciones se solapan, Jev puede elegir mal y hacerlo con mucha seguridad. Los tipos garantizan la forma de la caja, no que su contenido sea cierto.
La documentación de TypeSafe sobre las limitaciones de Jev 1.13 señala aspectos concretos que conviene tener presentes:
- Interpretación literal: el sarcasmo, las relaciones implícitas, el sentido común complejo y el lenguaje indirecto pueden confundirlo.
- Matemáticas y recuentos: los cálculos exactos, sumas y comparaciones de fechas corresponden al código.
- Ruido en estados largos: incluir documentos sin filtrar puede ocultar la evidencia importante.
- Criterios incompatibles: pedir a la vez algo más seguro, barato y creativo dificulta interpretar el resultado.
- Contenido adversarial: las instrucciones maliciosas y los intentos de confundir al modelo requieren defensas propias.
- Estructuras complejas: Jev no garantiza relaciones entre campos de un JSON anidado ni invariantes de bases de datos; valídalos con código.
- Generación abierta: no fue diseñado para redactar textos largos, resumir, explicar, conversar o escribir código.
También existe el riesgo de versión. jev-latest apunta a una versión nueva cuando TypeSafe la actualiza. Puede ser cómodo en una clasificación corriente; pero si una acción automática depende de un umbral calibrado, fija una versión como jev-1.13.0 y reproduce tus pruebas antes de actualizar. Pasar de 0,89 a 0,91 parece poco, pero puede cruzar un umbral y cambiar lo que experimentan los usuarios.
No automatices decisiones de alto impacto con una sola puntuación. Un diagnóstico médico, una conclusión jurídica, una decisión de crédito, un rechazo laboral, la suspensión de una cuenta, un pago o el borrado de datos requieren reglas estrictas, controles de acceso, trazabilidad y una revisión humana adecuada, incluso con confidence alta.
La forma más segura de llevar Jev a producción no es sustituirlo todo
Si ya tienes un flujo con un LLM que funciona, no empieces cambiando cada llamada por Jev. Busca una decisión frecuente, con pocas opciones, salida breve y errores fáciles de medir: si un resultado de búsqueda es relevante, a qué cola pertenece un ticket o si una llamada a herramienta parece anómala. Probar diez mil ejemplos históricos suele resolver la duda antes que discutir varias demostraciones.
Diseña un flujo de tres niveles
- Confidence alta y riesgo bajo: actúa automáticamente, por ejemplo, añade una etiqueta a un documento interno.
- Confidence intermedia: deriva el caso a un modelo generativo más capaz o recupera más información y vuelve a preguntar.
- Confidence baja o riesgo alto: pásalo a una cola humana; no finjas que el sistema sabe la respuesta.
No copies umbrales de otro artículo. Mide precisión, cobertura, coste de falsos positivos y coste de falsos negativos para tu tarea. Una mala recomendación quizá provoque un clic equivocado; un bloqueo de seguridad erróneo puede impedir que alguien trabaje. La misma probabilidad de Noul debe traducirse en políticas distintas según el contexto.
Conserva el registro completo de cada decisión
Guarda la versión del modelo y de la pregunta, una referencia rastreable al estado, las opciones, la distribución de probabilidad completa, el umbral y la acción final. Registrar solo billing pierde lo esencial: ¿obtuvo 0,91 frente a 0,05 o 0,36 frente a 0,34?
Deja el trabajo determinista al código
Sumar cantidades, comparar fechas, verificar permisos, validar máquinas de estado y hacer cumplir restricciones de unicidad no requieren un modelo neuronal. Coloca Jev en los límites ambiguos difíciles de formular como reglas, no en tareas que el código ya resuelve con exactitud. Un sistema maduro combina recuperación, limpieza de datos, juicios del modelo y muchos if, enumeraciones y validadores convencionales.
Vigila la degradación que puede traer un estado más largo
Cuando la inferencia cuesta poco, aparece la tentación de enviar más contexto. Menos coste por token no significa que la atención sea gratis. Reduce 200 resultados de búsqueda a 30 antes de llamar al modelo y envía los controles visibles y el texto cercano, no todo el DOM. Un buen preprocesamiento decide si las llamadas adicionales aportan algo.
Primeros pasos: plantea bien la pregunta en Playground
Abre TypeSafe Playground y prueba las tres primitivas con una docena de ejemplos reales. No empieces con un prompt gigante que pretenda cubrirlo todo. Formula una pregunta, revisa la distribución y luego prueba casos límite: falta de datos, opciones solapadas, sarcasmo, mucho ruido, expresiones coloquiales y erratas. Lo importante es descubrir cuándo empieza a dudar, no solo ver cómo responde a ejemplos fáciles.
Puedes llamar directamente a https://api.typesafe.ai/v1/systemone con jev-latest o una versión fijada. TypeSafe también ofrece un SDK para Python:
pip install typesafe-sdkPara Codex, Claude Code u otro agente compatible con skills, TypeSafe mantiene una skill oficial:
npx skills add typesafe-ai/skills --skill typesafe-aiLa skill no entrega mágicamente el control del agente a Jev. Le da instrucciones reutilizables para organizar el estado, escoger una primitiva y leer resultados cuando la tarea exige clasificar, puntuar o responder sí/no. La aplicación sigue decidiendo cuándo llamarlo, qué datos enviar y qué umbrales aplicar.
- Inicio rápido, API y Playground
- Versiones, precios y límites
- Skill oficial para agentes
- Acceso a través de OpenRouter
Para encontrar ideas, visita el directorio de casos de uso de Jev. Reúne 202 ejemplos públicos con sus autores y publicaciones originales. Fíjate en el pequeño punto de decisión donde cada uno incorpora Jev y busca un paso igual de acotado, repetitivo y costoso en tu producto.
Preguntas frecuentes sobre Jev
¿Jev es un modelo de lenguaje grande?
Es un modelo neuronal para tomar decisiones probabilísticas con salida tipada. No continúa un artículo: responde preguntas concretas sobre un estado mediante Choice, Score o Noul.
¿Puede manejar un navegador directamente?
No. Puede elegir qué opción pulsar a partir de un estado descrito en texto, pero otra herramienta debe leer la página, capturarla, hacer clic, escribir y esperar a que cargue.
¿Admite imágenes, audio o vídeo?
Jev 1.13 solo procesa texto. Convierte antes los medios con OCR, transcripción, detección de objetos u otro modelo multimodal y entrega un estado textual claro.
¿Puedo interpretar confidence como la precisión?
No. Confidence expresa cuán concentrada está la distribución del modelo; su calibración depende de la tarea, la formulación de la pregunta, el idioma y los datos. Mide precisión y cobertura con tus propios ejemplos antes de automatizar.
¿Puede reemplazar todas las llamadas a LLM?
No. Jev funciona bien con decisiones frecuentes, atómicas y enumerables. Para correos, resúmenes largos, explicaciones o código, sigue siendo más apropiado un modelo generativo.
¿Cómo integro Jev en Codex u otro agente?
Puedes llamar a la API de TypeSafe o instalar su skill oficial para que el agente reconozca cuándo delegar clasificaciones, puntuaciones y juicios binarios. Lo fundamental es dividir la decisión en preguntas atómicas y mantener el control final en el código.
Fuentes
La documentación oficial sirve para comprobar la interfaz, las versiones y las limitaciones. Las cifras de rendimiento del proveedor se identifican como evaluaciones propias; las pruebas independientes aportan contexto, no garantías universales.
- TypeSafe: Introducing System One Models and Jev — presentación, arquitectura y evaluaciones del proveedor.
- Documentación de TypeSafe: Introduction — Choice, Score, Noul y preguntas paralelas.
- Documentación de TypeSafe: Models — especificaciones de Jev 1.13, precios, idiomas y políticas de datos.
- Documentación de TypeSafe: Jev 1.13 Jaggedness — limitaciones conocidas.
- Documentación de TypeSafe: Confidence — confianza y enrutamiento según riesgo.
- TypeSafe Workflow Evals — evaluaciones del proveedor en cuatro flujos de trabajo.
- PrimeLine: A Pre-Registered Test of TypeSafe Jev — prueba independiente prerregistrada.
- Emil Lindfors: A First Look at TypeSafe’s Jev — prueba temprana en noruego.
- DataCamp: System One Models and Jev — análisis externo y límites de los benchmarks.
- Awesome Jev / TypeSafe — índice de proyectos de la comunidad.