
SNSではJevを「より速く、安く、ハルシネーションもしないLLM」と紹介する投稿をよく見かけます。印象的な表現ですが、肝心な点が逆です。Jevの価値は文章生成の上手さではなく、そもそも自由文を生成することを主な仕事にしていない点にあります。
Jevを一言でいうと
**JevはTypeSafe AIが提供する、確率に基づく構造化意思決定モデルです。**テキストの状態と、範囲を明確にした質問を渡すと、選択肢・スコア・「はい」の確率を返します。アプリ側で文章を再解析する必要はありません。TypeSafeはこの方式を「非構造化状態を入力し、型付きの確率的判断を出力する」と説明しています。
たとえばサポートチケットを考えてみましょう。一般的なチャットモデルなら「お客様は不満そうです。請求に関する問題かもしれず、早めの対応がよさそうです」と答えるかもしれません。人には自然でも、プログラムから見ると、請求の問題なのか、不満の程度はどのくらいか、エスカレーションすべきかが曖昧です。結局、解析処理やルール、フォールバックを追加することになります。
Jevなら、あらかじめアプリで定義した判断項目に沿って結果を返せます。
これは文章のスタイルではなく、システムの境界の違いです。前者は文章の中に判断を隠し、後者はソフトウェアが直接使える値として判断を返します。毎日何十万回もルーティング、フィルタリング、並べ替え、安全確認を行うエージェントでは、文面から答えを推測する工程を一つ省けることが、最終回答を賢そうに見せることより重要な場合があります。
**まず機能の境界を押さえてください。**Jevはブラウザー操作ツールでも画像認識モデルでもありません。ページの取得、スクリーンショットの読み取り、クリックや入力はEgo、Playwrightなどのエージェントツールが担当します。Jevはそれらが用意したテキスト状態を読み、次のアクション候補を選べます。Jev 1.13はテキスト専用で、画像・音声・動画を直接扱えません。
誕生の背景:「System One」は単なる速さの宣伝ではない
TypeSafe AIは2026年9月15日にJevを発表し、初の公開System One Modelと位置づけました。System Oneという呼び方は、ダニエル・カーネマンが一般向けに説明した「システム1」の思考——素早く、直感的で、ほぼ自動的な判断——に由来します。Jevという名前は、19世紀の経済学者ウィリアム・スタンレー・ジェヴォンズと「ジェヴォンズのパラドックス」を踏まえています。効率が上がっても、利用コストが下がれば資源の総消費はむしろ増えることがある、という考え方です。
この命名には製品としての仮説もあります。一回の判断が十分安くなれば、開発者は既存のLLM呼び出しを置き換えるだけでなく、以前はモデルを呼ぶほどではなかった小さな判断にもモデルを使うようになります。このメールは通知する価値があるか、検索結果は本当に関連しているか、画面上のどのボタンなら次に進めるか、ログのどの部分を人に確認してもらうか。ひとつひとつは小さくても、自動化システムの日常を形づくる判断です。
TypeSafeはJevの学習方法をRLCD(Reinforcement Learning for Calibrated Decisions)と呼んでいます。学習を独立に再現できるほどの詳細は公開されていないため、この名称だけで査読済みの手法だとは言えません。確認できるのは製品インターフェースです。出力は自由文ではなく確率分布で、同じ状態に対する複数の独立した質問をまとめて実行でき、自動化・人手確認・停止のしきい値は開発者が決められます。
TypeSafeの共同創業者Diogo Almeidaは初期のRLHFやInstructGPTの仕事にも参加していました。その経歴は、モデルの出力をソフトウェアにどう組み込むかをチームが重視する理由の一つかもしれません。ただし、経歴はモデル性能の証明ではありません。Jevが業務に合うかどうかは、実際のデータ、誤りのコスト、運用上のしきい値で判断する必要があります。
中心にあるのはプロンプトではなく、3つの意思決定プリミティブ
Jevのドキュメントで最初に注目したいのは価格ではなく、質問の表現をどのように制限しているかです。主なプリミティブはChoice、Score、Noulの3つ。あえてすべての表現形式を扱わないことが、信頼性につながります。
Choice:既知の候補から1つ選ぶ
Choiceはルーティングや分類に使います。refund、billing、technical、otherのような候補を渡すと、選択結果、各候補の確率、confidenceが返ります。公式ドキュメントでは、1つの質問につき候補は最大255個です。それ以上ある場合は、先にScoreで候補を絞り、その上位にChoiceを使えます。
Choiceが答えるのは「どれか」です。複数の基準をひそかに混ぜるのには向きません。「最も緊急で、解決しやすく、顧客価値も高いチケットを選んで」という質問には3つの目的が混在しています。緊急度、解決の難しさ、顧客価値を別々に尋ね、並べ替えはコードで行う方が明確です。見た目は控えめでも、テストしやすく、問題の切り分けも簡単になります。
Score:離散的な尺度で評価する
Scoreは指定した範囲の値に加えて、スコアごとの確率分布とconfidenceを返します。関連性、リスク、品質、感情の強さ、優先度などに使えます。尺度には説明可能な意味を持たせましょう。「良いか」と聞くのではなく、0・5・10がそれぞれ何を示し、値の違いをどう解釈するのか定義します。
スコアはラベルより精密に見えるため、実際以上の確かさを感じさせることがあります。8点と9点で業務上の対応が変わらないなら、後続処理で別扱いする意味はありません。必要なアクションの段階数を先に決めてから尺度を設計します。
Noul:「はい」の確率を返す
Noulは最小単位の判断です。「この文に個人情報が含まれるか」「ユーザーは明確に返金を求めたか」「この結果は検索意図に合っているか」のような質問に向いています。0から1の確率を返し、別のconfidence項目はありません。しきい値は呼び出す側が決めます。0.6で無害な画面メッセージを出すのはよくても、アカウント停止、課金、データ削除の根拠にするには不十分です。
実務上の分担は明快です。モデルは不確実性を扱い、ポリシーはコードで決めます。「不正である確率は87%」はモデルの判断です。「95%以上なら自動遮断し、80〜95%は人の確認に回す」は業務ポリシーです。分けておけば、モデルを再学習しなくてもリスク許容度を調整できます。
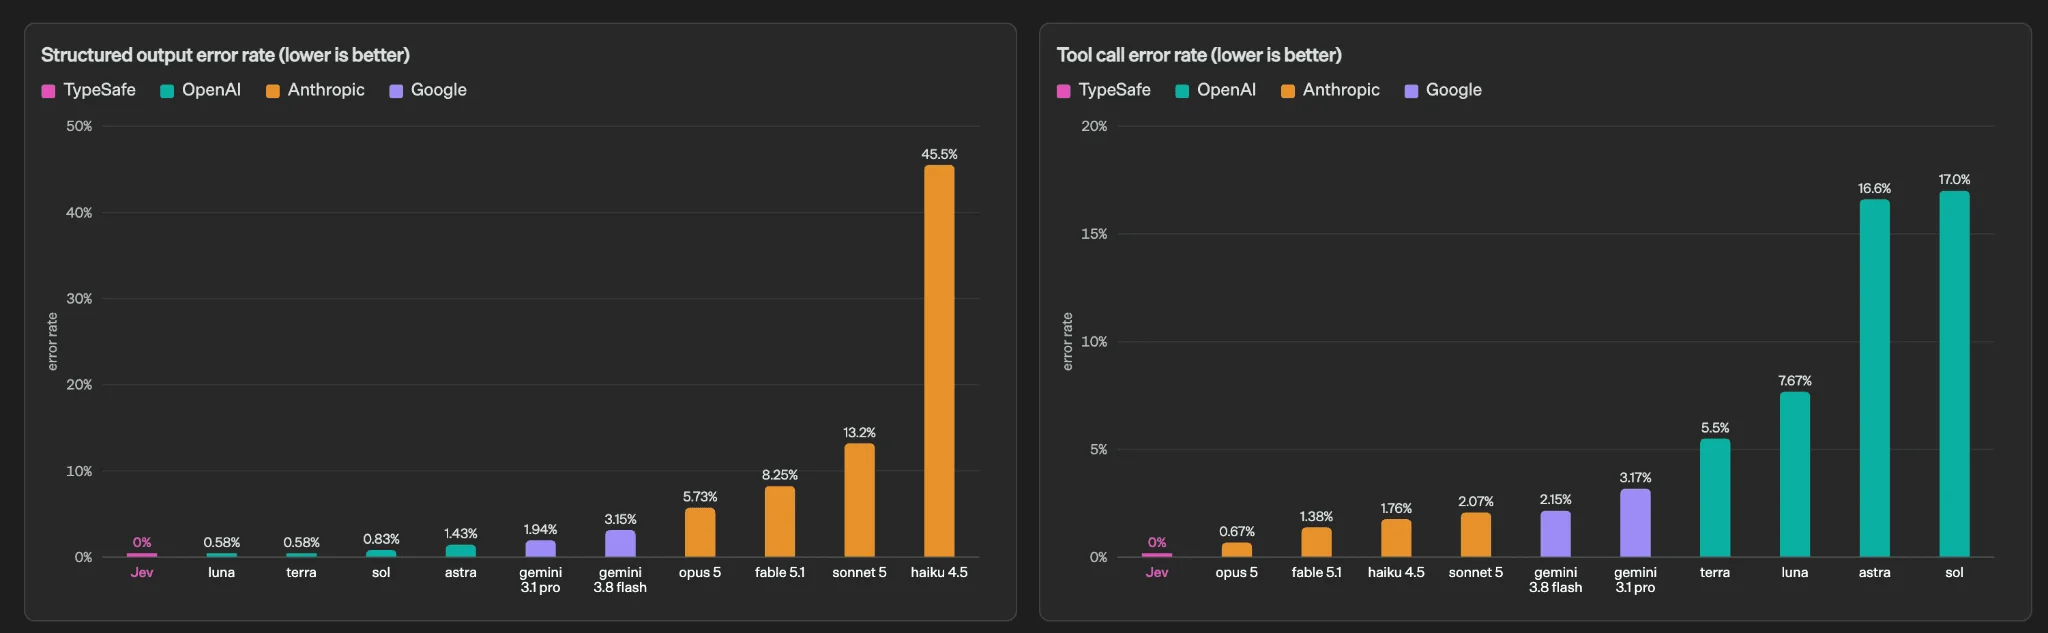
リクエストの流れ:状態、質問、確率、コード
リクエストには、すべての質問で共有するstate、モデル名、複数のquestionsを含めます。stateには各質問が参照する根拠をまとめます。メール、サポートチケット、検索結果、ツール呼び出しの記録、簡略化したアクセシビリティツリーなどです。複数の質問は同じ状態を個別に読み取るため、後の質問が前の回答に自動的に依存するわけではありません。
POST https://api.typesafe.ai/v1/systemone

{
  "model": "jev-latest",
  "state": "Customer says the invoice is duplicated and asks for a refund...",
  "questions": [
    { "type": "choice", "question": "Which team owns this ticket?", "options": ["billing", "support", "security", "other"] },
    { "type": "score", "question": "How urgent is this request?", "min": 0, "max": 10 },
    { "type": "noul", "question": "Does the customer explicitly request a refund?" }
  ]
}
この形なら長いルールの連鎖を置き換えられますが、質問同士は独立しています。3つ目の質問を1つ目の回答に依存させたい場合は、呼び出しを分けるか、Jevに基礎的な判断を出させたうえでコードで組み合わせます。
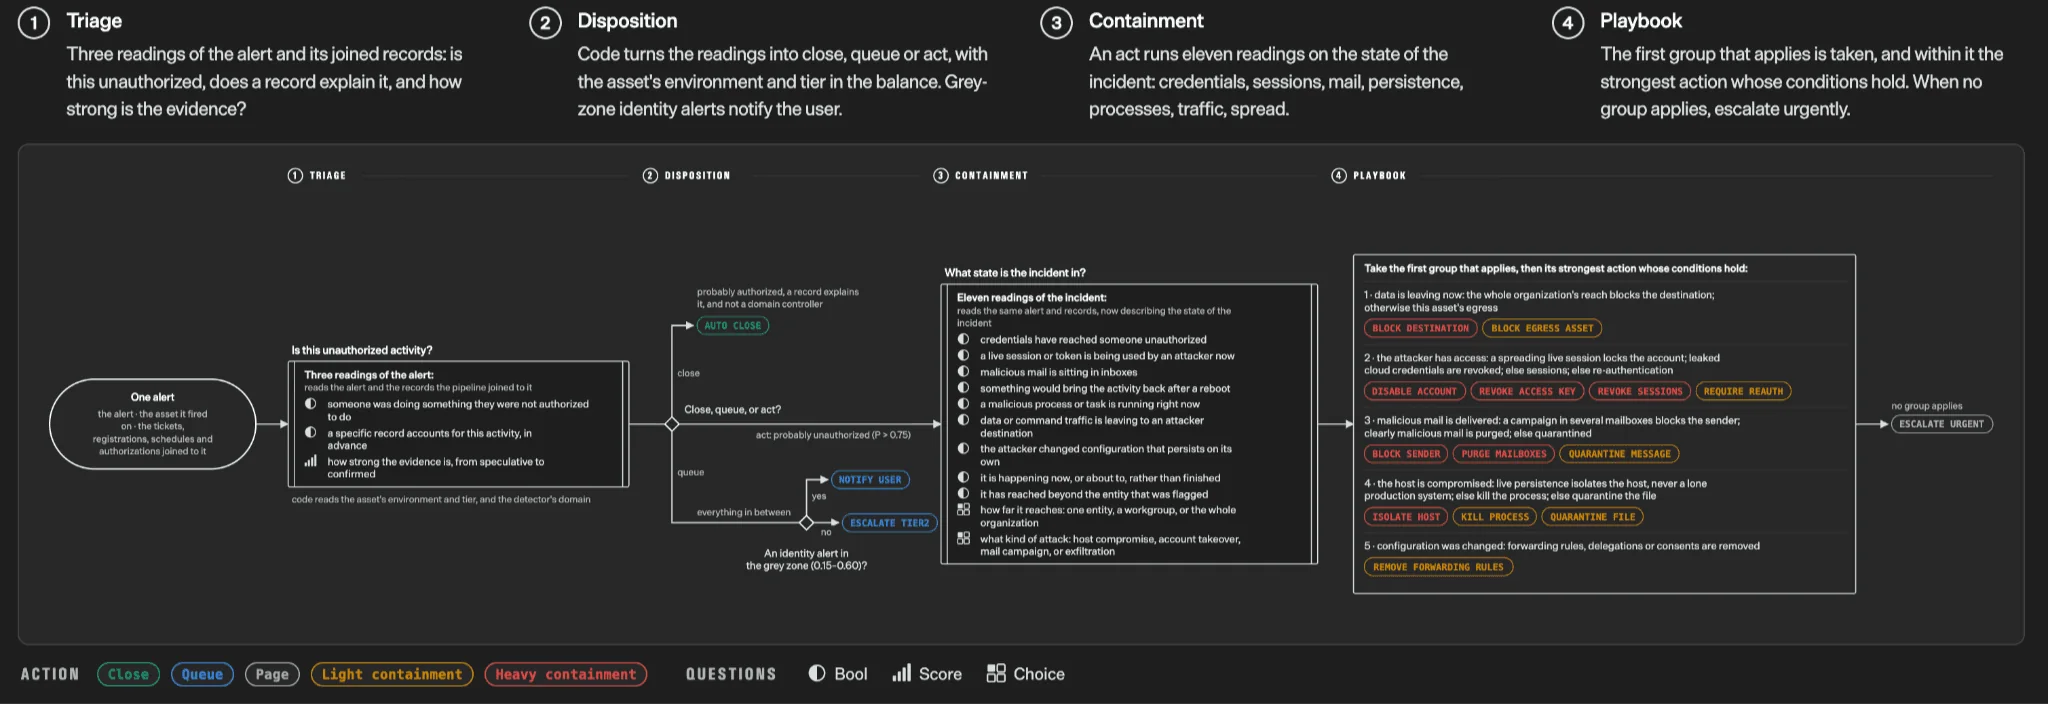
参考になるのは責任の分担です。何でも「万能プロンプト」に詰め込むのではなく、曖昧な判断をJevに任せ、真偽値の組み合わせ、しきい値、権限、外部への副作用は監査できるコードに残します。
どれほど速く、安いのか——3種類の根拠を分けて見る
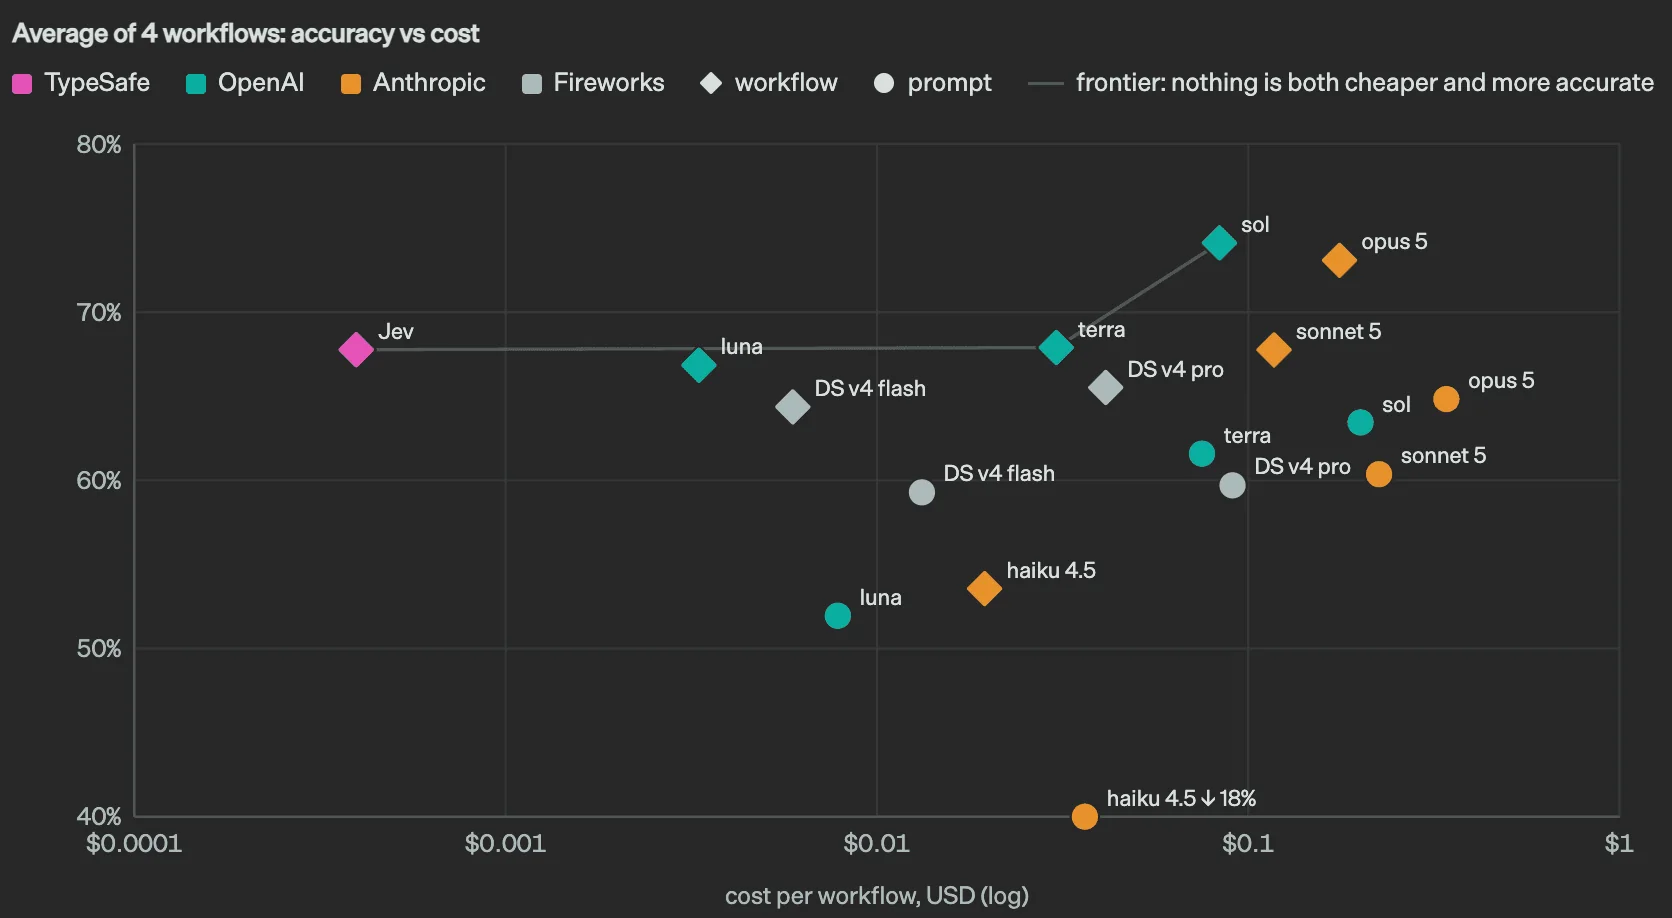
Jevが広く知られた理由の一つは数字です。執筆時点でTypeSafeのモデルページには、Jev 1.13の入力料金は100万トークンあたり0.042米ドル、出力料金は無料と記載されています。公称スループットは毎秒最大25万トークン、毎分1,200リクエストです。発表記事では通常のレイテンシを70〜500ミリ秒とし、System Oneに適したタスクでは従来の推論モデルより40〜200倍速いと主張しています。
数字は次の3段階に分けて読みましょう。
- 製品仕様: 価格、コンテキスト長、レート制限は提供会社が管理する利用条件です。導入前にモデルページで確認してください。
- ベンダー評価: TypeSafeは社内の4つのワークフローで、最大約193.6倍の速度と約444.6倍のコスト優位を報告しています。会社自身が最大値にあたると説明しており、参照ラベルはAstraとFableの出力平均です。評価設計が自社方式に有利に働く可能性もあります。
- 独立した観察: 別の視点として参考になりますが、現在の検証はタスク、言語、サンプル数が限られています。単一の結果をあらゆる業務に当てはめることはできません。
事前登録された独立テストでわかったこと
PrimeLineは3つの事前登録テストを設計し、2種類の実作業でJevの4バージョンを評価しました。API呼び出しは約9,750回、費用は0.38米ドルです。2,600件のサンプルをまとめたテストでは、confidenceが0.9以上の予測は約92%正解で、対象の約73%をカバーしました。0.8未満では結果が五分五分に近づいています。
注目すべきなのは「92%」という見栄えのする数字だけではありません。confidenceの高い例は自動化し、不確かな例は高性能モデルや人に回すという、棄却を含むルーティングの可能性です。レポートではプリミティブ別の較正誤差にも大きな差があり、Noulは約0.012、Choiceは約0.086、Scoreは約0.254でした。サンプル条件は完全には同じでないものの、すべての質問で同じconfidenceしきい値が機能するとは限らないことが分かります。
ノルウェー語での初期テストが示すこと
Emil Lindforsは、ノルウェー語の相談資料24件でJevを試しました。公開例の一つでは正解ラベルを外しましたが、確率分布には迷いが表れていました。11個の質問、約4,995入力トークンを含む呼び出しは約0.31秒でした。実開発の感触に近い結果です。応答は速い一方、型付きのAPIにしても誤りはなくなりません。
コンテキスト上限には2つ補足があります。TypeSafeはJev 1.13の総コンテキストを64k、stateと最長の質問の合計を32kとしています。一方、OpenRouterのページでは32kと表示されています。各サービスの数え方が異なる可能性があるため、実際に使うエンドポイントを確認してください。またTypeSafeは英語が最も得意だと説明しています。中国語、日本語、韓国語などの安定性には差があり得るため、利用する言語とデータでしきい値を調整しましょう。
Jevの主な活用例
公開プロジェクトやデモを見ると、「Jevのチャットボット」を作るより、プロンプトの連鎖、小型モデルの呼び出し、壊れやすいルールが担っていた小さな判断にJevを組み込む例が目立ちます。公開事例はJev活用事例の一覧に202件掲載しています。
1. エージェントのルーティング:次のツールを選ぶ
ユーザーの依頼を受けたエージェントは、検索する、コードを書く、データベースを調べる、追加質問をする、といった選択を迫られます。小型LLMでJSONを出したり、キーワード規則を使ったりするのが一般的です。Choiceでツールを選び、Scoreで高価なモデルを使う価値があるか見積もり、Noulで続行に必要な情報が揃ったか判断できます。高頻度のエージェントでは、最終回答よりルーティングの方が何度も実行されます。
2. 検索と検索結果の再評価
オープンソースのjev-searchは、控えめで分かりやすい使い方を示しています。Jevが検索元、期間、検索方針を選び、結果を関連度順に並べ替えますが、最終回答は生成しません。検索システムには小さな判断が多く必要でも、毎回文章を出す必要はありません。
3. ブラウザー自動化:次の操作候補から選ぶ
ブラウザーエージェントは、ページを理解した後で「次にどこを押すか」に迷うことがあります。アクセシビリティツリー、ボタンのラベル、タスクをテキスト状態にまとめ、候補操作からJevに選ばせます。ページを読み、クリックするのは引き続きブラウザーツールです。Jevはテキストで示された候補を選びます。
4. 安全性と可観測性:実行の記録にラベルを付ける
エージェントの実行記録には、何十回ものツール呼び出しが含まれることがあります。知りたいのは、権限を越えようとしたか、機密情報が漏れたか、計画・ツール・環境のどこで失敗したかです。監視システムが必要とするのは最終的にラベル、スコア、エスカレーション判断です。Jevの出力形式は長い所見文よりもこうした用途に合います。
5. コンテンツと業務データの一括処理
商品分類、レビューの意図、見込み客の評価、返金理由、請求書の異常、コンテンツ審査には共通点があります。件数が多く、1件あたりの価値は限定的で、誤りのコストに段階を付けられ、結果の候補が比較的安定しています。1日100件なら多くのモデルで処理できますが、100万件になるとレイテンシとトークン単価が構成を変えます。
6. ゲーム、ロボット、リアルタイム操作
TypeSafeのDoomデモは「Jevが画面を見てゲームをプレイする」と紹介されることがあります。しかし公式説明によれば、入力はピクセルではなく構造化されたテキスト状態です。体力、弾薬、敵、周囲の説明をもとにJevが操作を選び、ゲーム側の制御層が実行します。これは低レイテンシな意思決定の例であり、視覚理解の実証ではありません。ロボットの上位操作選択にも似た構成を応用できますが、認識、モーター制御、安全制約には別の仕組みが必要です。
7. 反例も参考になる:Choiceで文章を生成する
コミュニティのjev-llmは、次のトークンを繰り返しChoiceで選び、Jevに文章を書かせる実験です。面白い試みですが、Jevの強みから外れた使い方を示す例でもあります。ドライバーで釘を打つことはできても、最適な道具とは限りません。文章作成、要約、説明、コード生成には生成モデルを使いましょう。
構造化されていても、正しいとは限らない
数値を求めたのにMarkdownが返ってくる、といった形式の問題はJevで避けやすくなります。しかし、意味として正しいかどうかは別です。stateに重要な情報がない、質問が曖昧、選択肢が重なっている場合、Jevは自信を持って間違える可能性があります。型が保証するのは箱の形であり、中身の正しさではありません。
TypeSafeのJev 1.13に関する制約の説明には、次の点が挙げられています。
- 字義どおりに解釈しやすい: 皮肉、暗黙の関係、複雑な常識、遠回しな表現は不安定になり得ます。
- 計算とカウント: 正確な算術、合計、日付の比較はコードで処理します。
- 長い状態に含まれるノイズ: 資料を選別せず渡すと、重要な根拠が埋もれます。
- 基準の衝突: 「より安全で、安く、創造的に」と一度に尋ねると結果の解釈が難しくなります。
- 敵対的な入力: state内のプロンプトインジェクションや意図的な混乱には、専用の対策が必要です。
- 複雑な構造: ネストしたJSONの関係、フィールド間の制約、データベースの不変条件は保証されません。コードで検証してください。
- 自由形式の生成: 長文、要約、説明、会話、コード生成を目的に設計されたモデルではありません。
バージョンにも注意が必要です。jev-latestは提供元の更新に応じて別バージョンを指すようになります。一般的な分類なら便利ですが、較正済みしきい値で自動処理する場合はjev-1.13.0のような固定バージョンを指定し、更新前に過去データを再実行してください。確率が0.89から0.91に少し変わっただけでも、本番のしきい値をまたいでユーザーへの処理が変わることがあります。
**高リスクな判断を単一スコアだけで自動化しないでください。**医療診断、法的判断、与信、採用の不合格、アカウント停止、課金、データ削除には、confidenceが高く見えても、明確なルール、アクセス制御、監査記録、適切な人による確認が必要です。
本番では「すべて置き換える」より、小さく始める
すでに動いているLLMのフローがあるなら、最初からすべての呼び出しをJevに置き換えるべきではありません。頻繁に実行され、短い候補から選び、誤りを測りやすい判断を一つ探してください。検索結果が関連するか、チケットの担当キューはどこか、ツール呼び出しに異常があるか、といった判断です。デモを議論するより、過去の1万件を再生してみる方が早く答えが出ます。
3段階の判断フローを作る
- 確信度が高く、リスクが低い: 社内文書へのタグ付けなどは自動で実行します。
- 確信度が中程度: より強い生成モデルに渡すか、追加情報を検索してからもう一度判断します。
- 確信度が低い、またはリスクが高い: 人の確認キューに送ります。システムに分かったふりをさせません。
他のブログのしきい値をそのまま使わず、タスクごとに適合率、カバレッジ、誤検知・見逃しのコストを測ります。推薦ミスならクリックを一度逃すだけかもしれませんが、安全機能の誤判定はユーザーの作業を止めることがあります。同じNoul確率でも状況によって必要なポリシーは違います。
判断の記録をすべて残す
モデルと質問のバージョン、参照可能なstate、候補、確率分布全体、しきい値、実行したアクションを記録します。billingという結果だけを保存しても重要な情報は失われます。billingが0.91対0.05だったのか、0.36対0.34だったのかを確認できません。
決定的な処理はコードに任せる
金額の合計、日付の比較、権限確認、状態遷移の妥当性、一意性の保証にニューラルモデルは不要です。Jevは規則だけでは表しにくい曖昧な境界に使い、コードが正確に処理できる仕事を任せないようにします。Jevを使う成熟したシステムも「すべてAI」ではありません。検索、データ整形、モデルの判断に、普通の条件分岐や列挙型、バリデーターを組み合わせます。
stateが長くなって性能が落ちる兆候を見る
推論が安くなると、コンテキストを増やしたくなります。しかし、トークン料金が下がっても注意力が無料になるわけではありません。検索結果200件を渡す前に条件で30件に絞り、ページのDOM全体ではなく見える操作要素と周辺のテキストを残します。呼び出しを増やす価値があるかは、前処理の質に左右されます。
使い始めるには、まずPlaygroundで質問を磨く
TypeSafe Playgroundを開き、実例を十数件使って3つのプリミティブを試します。どんなケースも扱う巨大なプロンプトから始めないでください。質問を一つ作って確率分布を見たら、情報不足、候補の重複、皮肉、長いノイズ、口語表現、誤字といった境界例を試します。簡単な入力での見栄えより、どこで判断に迷うかを知ることが大切です。
https://api.typesafe.ai/v1/systemoneを直接呼び出し、jev-latestまたは固定バージョンを指定できます。TypeSafeはPython SDKも提供しています。
pip install typesafe-sdkCodex、Claude Codeなどskillsに対応したエージェント向けに、TypeSafeは公式skillを公開しています。
npx skills add typesafe-ai/skills --skill typesafe-aiこのskillを入れても、Jevがエージェントを自動的に制御するわけではありません。分類・採点・二択判断が必要なときに、stateのまとめ方、プリミティブの選び方、結果の読み方をエージェントが参照できるようにします。呼び出すかどうか、どのデータを送るか、しきい値をどうするかは、引き続きアプリと運用ポリシーが決めます。
アイデアを探すなら、Jev活用事例の一覧を見てください。作者と元投稿へのリンク付きで、公開事例を202件掲載しています。Jevがどんな「小さな判断」に置かれているのかを見て、自分の製品にある似た工程を探すとよいでしょう。
Jevについてよくある質問
Jevは大規模言語モデルですか?
テキストを扱うニューラルモデルですが、チャット型LLMとは製品の役割が異なります。文章の続きを書くのではなく、stateと質問に対してChoice、Score、Noulなどの制約された確率的判断を返します。
Jevだけでブラウザーを操作できますか?
できません。ページ状態からクリックする候補を選ぶことはできますが、ページを読み取り、スクリーンショットを撮り、クリック・入力し、読み込みを待つ処理はブラウザー自動化ツールが行います。
画像、音声、動画に対応していますか?
Jev 1.13はテキスト専用です。画像・音声・動画はOCR、音声認識、物体検出、他のマルチモーダルモデルなどで分かりやすいテキスト状態に変換してから渡してください。
confidenceを正解率として扱えますか?
同じものとして扱うべきではありません。confidenceは現在の確率分布がどの程度集中しているかを表し、較正の度合いはタスク、質問文、言語、データ分布によって変わります。自分のデータでカバレッジと正解率の関係を調べてから自動実行のしきい値を決めてください。
すべてのLLM呼び出しを置き換えられますか?
できません。Jevが得意なのは高頻度で原子的、候補が定義された判断です。メール作成、長文要約、説明、コード生成などには生成モデルが向いています。
CodexなどのエージェントにJevを組み込むには?
TypeSafe APIを直接呼び出すか、公式agent skillを導入します。重要なのは判断を小さな質問に分け、最後の制御権をコードに残すことです。
参考資料
APIの仕様、バージョン、制限は公式ドキュメントを優先して確認しています。TypeSafe自身による性能測定はベンダー評価として示し、独立テストは普遍的な保証ではなく補足資料として扱っています。
- TypeSafe: Introducing System One Models and Jev — 発表、アーキテクチャ、ベンダー評価。
- TypeSafe Docs: Introduction — Choice、Score、Noul、複数質問。
- TypeSafe Docs: Models — Jev 1.13の仕様、価格、対応言語、データポリシー。
- TypeSafe Docs: Jev 1.13 Jaggedness — 既知の制約。
- TypeSafe Docs: Confidence — confidenceとリスク別ルーティング。
- TypeSafe Workflow Evals — 4つのワークフローに関する公式評価。
- PrimeLine: A Pre-Registered Test of TypeSafe Jev — 独立した事前登録テスト。
- Emil Lindfors: A First Look at TypeSafe’s Jev — ノルウェー語による初期検証。
- DataCamp: System One Models and Jev — 第三者の概要とベンチマーク上の注意点。
- Awesome Jev / TypeSafe — コミュニティプロジェクト集。