
新一代旗舰模型最容易被问到的问题,是“它又比上一代聪明了多少”。但对 Claude Fable 5.5,更值得问的是:当便宜的模型已经能完成大量复杂工作,旗舰还能在什么地方创造足够大的差异?
答案可能藏在三个地方:长任务中的判断力、把研究变成可以检验的成果,以及完成同一份工作所需的总成本。我们重新检索官方文档、研究材料和独立评测,尝试把 Fable 5.5 放回这条技术演进线上。本文是一篇基于公开资料的前瞻分析;社区作品另见专题案例库。
Fable 5.5 走到了哪一步?
截至 2026 年 10 月 3 日,我们查阅的 Anthropic 模型目录仍列出 Fable 5.1;新闻页没有给出 Fable 5.5 的正式公告。名称、发布日期、API ID、定价和评测成绩,尚不能作为已发布产品信息来写。
关于新预训练、版本改名与发布时间的讨论已经流传了一段时间。CellCog 9 月 23 日的资料追踪梳理了 5.2 与 5.5 两种称呼的传闻链。这是一份第三方追踪材料,其当时的核查日期也早于本文;它提供线索,不能替代官方发布。
阅读约定:下文明确标出 5、5.1 和 Opus 5.5 的已知事实;谈到下一代 Fable 时,会使用“值得观察”“可能的方向”等分析措辞。已有版本的规格、图表与研究成果不等于 Fable 5.5 的实测。
为什么已经有 Opus,还需要 Fable?
Claude 的产品线越来越像按工作复杂度分配的团队。当前模型目录建议大多数任务先从 Opus 5.5 开始,把 Fable 5.1 留给更困难的推理与长时程 Agent 工作。旗舰的价值因此不必体现在每一封邮件上,而可能出现在普通模型解决不了、或者反复返工的少数任务里。
Fable 5.1 的技术更新文档把能力改进分为长时间编程、文档和表格工作、研究检索、视觉、长上下文与电脑操作。这个列表说明,Fable 的目标不是一种单独的创作风格,而是复杂工作中从阅读、计划、执行到交付的连续性。
这也是我们对 5.5 最核心的期待:当任务没有现成答案、需要跨多个文件或工具、还必须检查自己的结果时,它能否减少人的接管次数?这属于值得验证的产品方向,尚不是一个已经实现的 5.5 特性。
旗舰的门槛,被 Opus 5.5 抬高了
Opus 5.5 发布介绍展示了一组明确版本的厂商评测。以下重绘三项与编程和研究相关的分数:同一发布页中的 Opus 5.5 与 Fable 5.1。它们构成观察下一代 Fable 的基线,而不是 5.5 的预测分数。
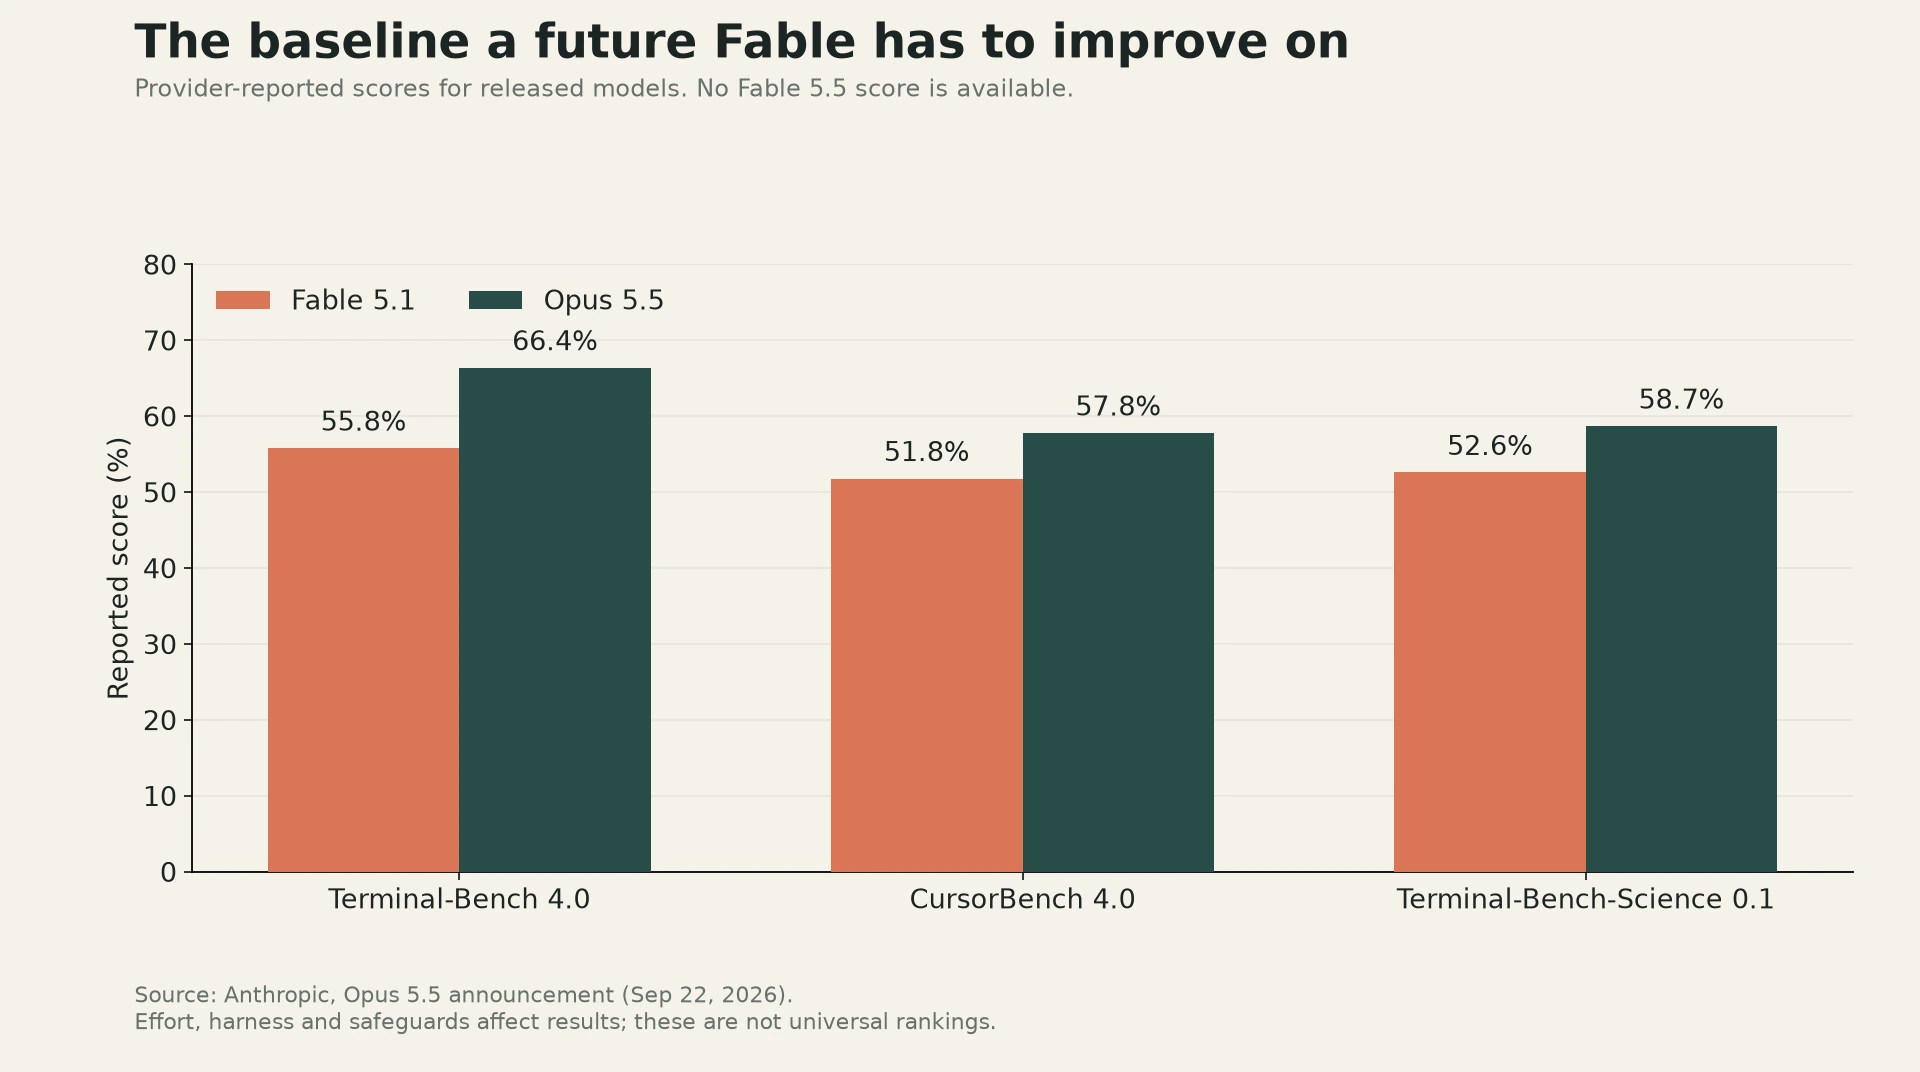
看起来,下一代 Fable 必须给出一个比“名称更高级”更具体的购买理由。但图表也容易让人误判。Snorkel 的独立研究在 24 个终端编程任务上,同时报告了 pass@1、pass@5 和全部轨迹通过率。以 pass@1 看,Fable 5.1 是 61.5%,两代 Opus 都是 60.7%;以全部轨迹看,三者分别是 49%、61%、68%。统计口径一变,结论就变了。
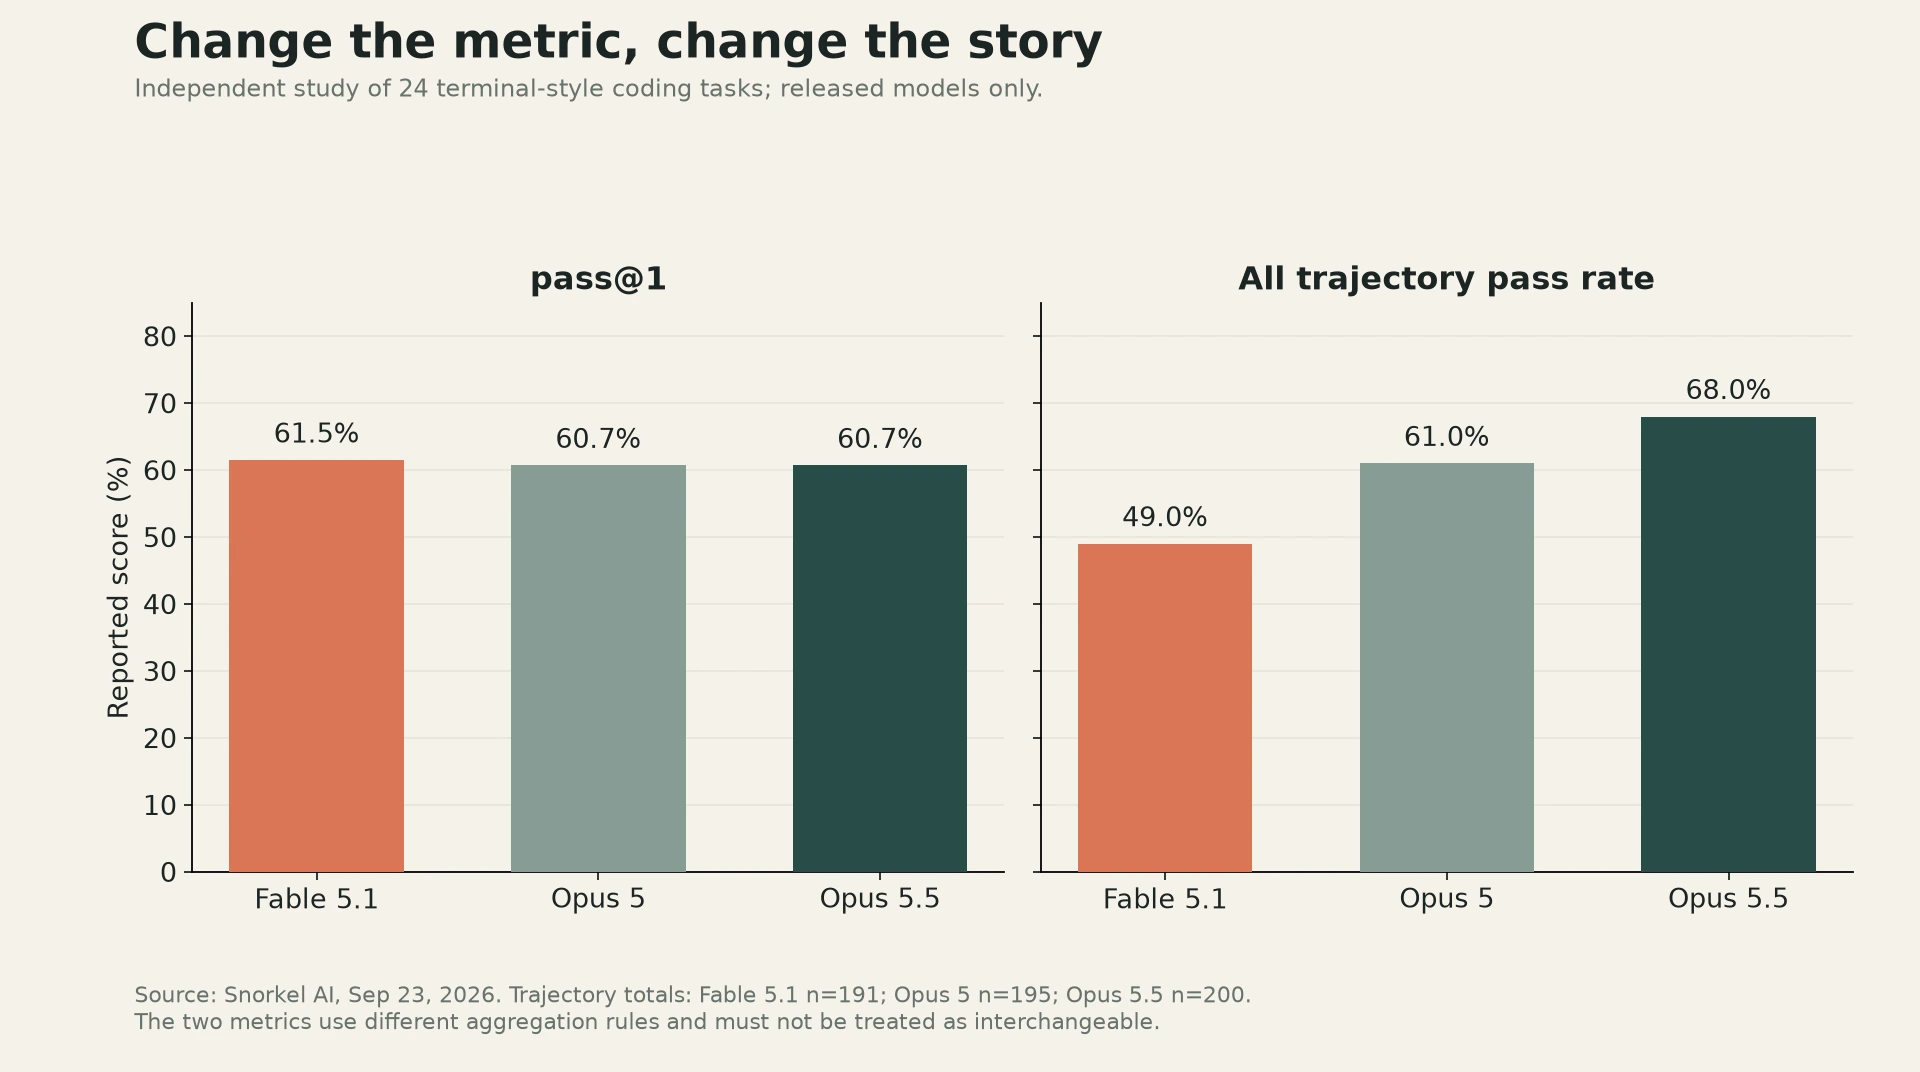
我们的判断是,旗舰更应该用“在困难任务上节省了多少次失败”来证明自己,而不是要求所有榜单都排第一。实际评估时,任务难度、重复次数、执行框架和失败定义,比一个脱离上下文的百分数更重要。
从写答案,到做一项可以复查的研究
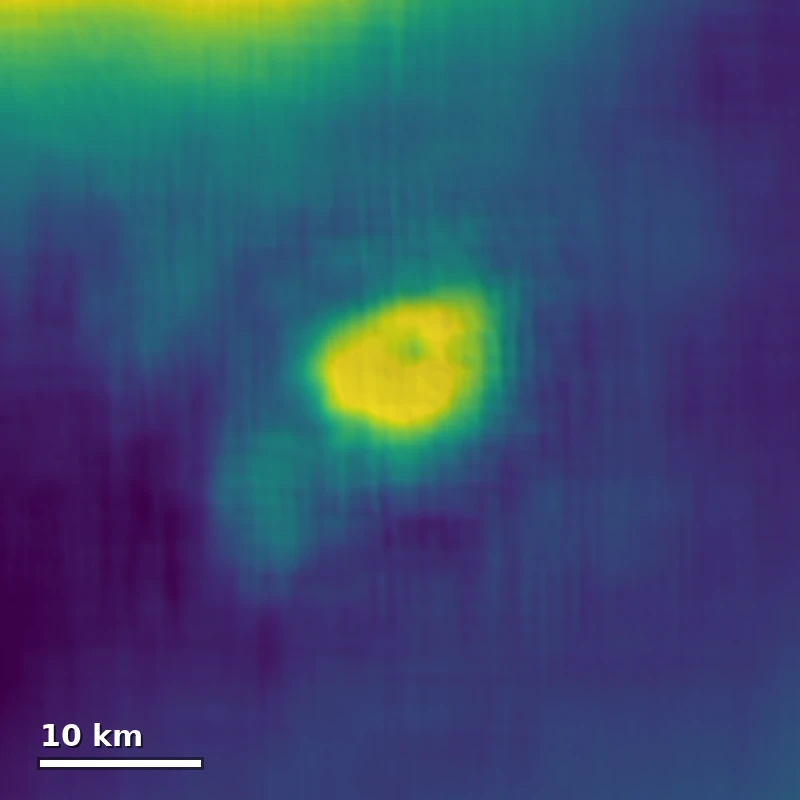
真正能把旗舰拉开距离的,也许是把复杂研究变成可检查产物的能力。一个已经公开的例子来自 Fable 5.1,而非 5.5:Anthropic 介绍它利用 Magellan 雷达资料训练模型,重建金星部分区域的地形。官方展示了原始雷达图、旧测高结果与新 DEM,并链接到公开数据。 Fable 5.1 发布材料
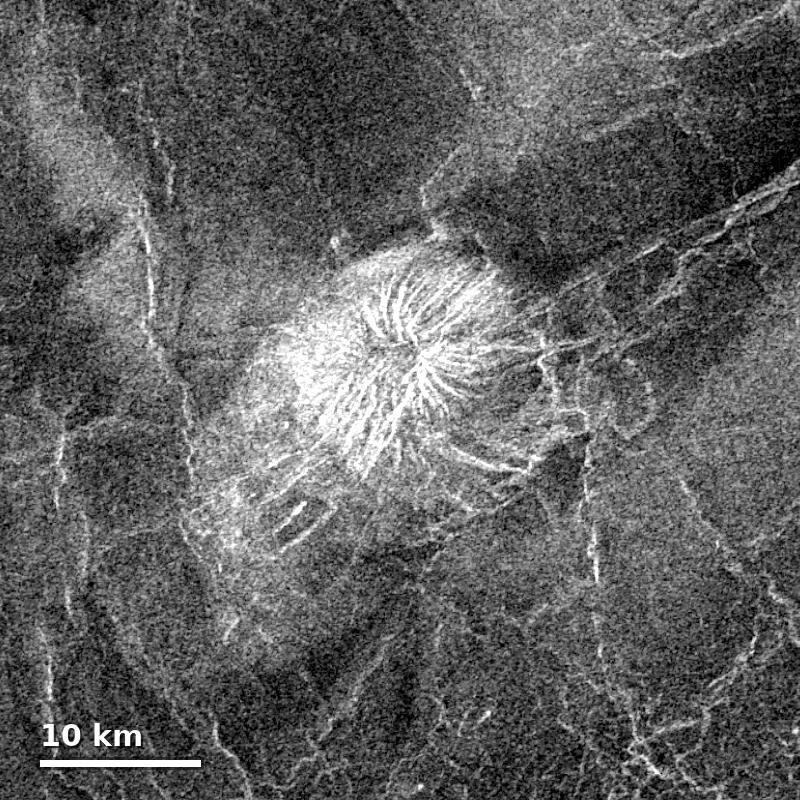 Magellan radar
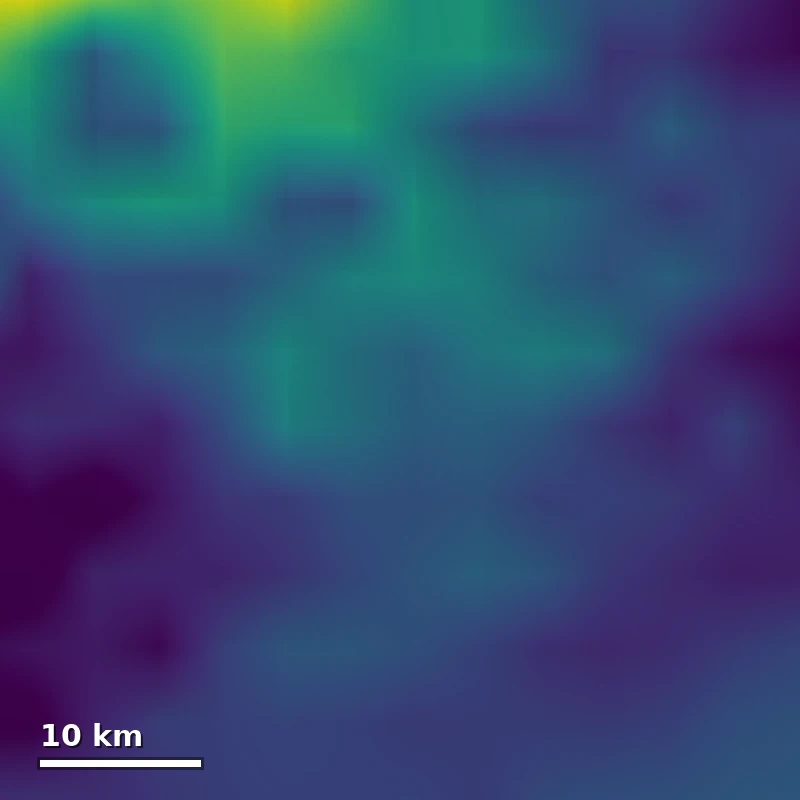 Previous altimetry
 New DEM
Zenodo 的 Venus Opposite-Look Topography 记录提供数据文件、README、许可文件与引用信息。这种交付形态值得关注:读者不仅看到一个结论,还能追问输入是什么、处理步骤是什么、产物怎样被其他人使用。
从这个角度看,下一代 Fable 的潜在价值不是“知道更多名词”,而是能否把问题拆成实验、执行计算、留下证据,并在结果不成立时改正方向。模型生成的漂亮文字和真正经过验证的研究之间,仍隔着数据质量、方法选择与领域审查。这些是我们认为应观察的能力,不能由现有研究直接推定到 5.5。
一个好 Agent,需要怎样的工作方式?
Anthropic 的模型编排专题介绍了 advisor 策略:较便宜的模型做日常执行,Fable 提供策略与困难步骤的指导。这份资料针对 Fable 5,是理解产品方向的历史背景,不是 5.5 的新功能公告。
下面是我们据此整理的一种应用设计。它解释角色分工,不是 Anthropic 内部模型架构。
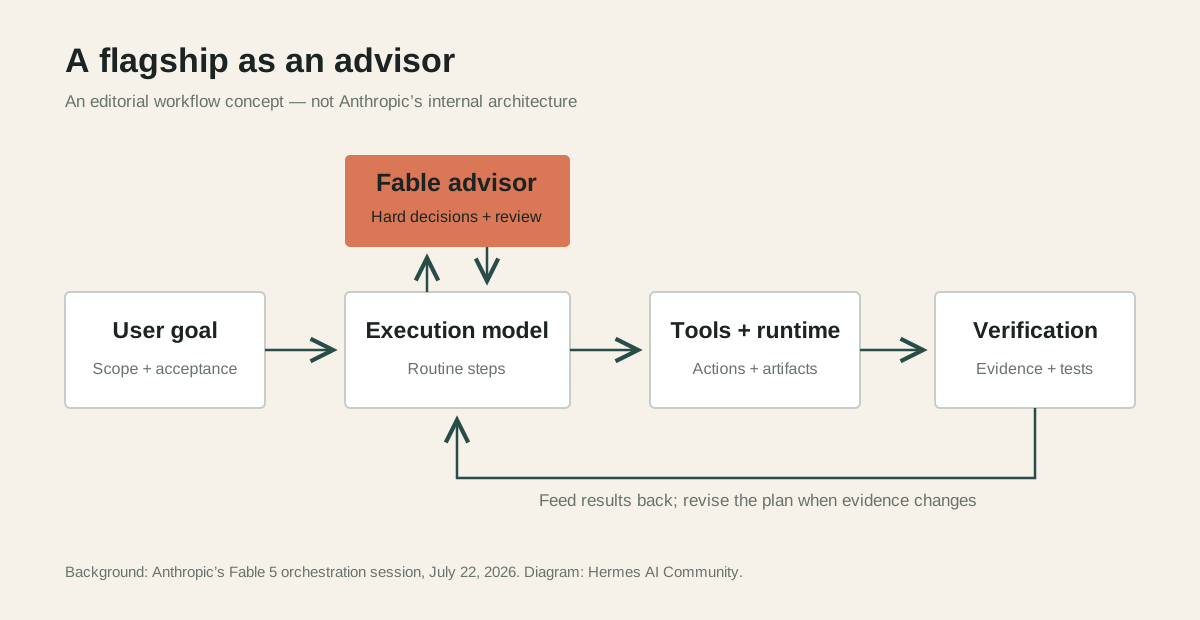
要让这种分工好用,执行结果必须回流给决策者,任务完成也必须有验收依据。否则,“多模型”只是多了一层通信。值得测试下一代旗舰的任务,可以是定位一个反复出现的根因、评审一份迁移方案,或判断一条研究路线是否值得继续。
与此相关的 API 设计已经能在 Fable 5.1 文档中找到:中途调整 effort、限定到单轮的系统消息,以及工具调用之间的可读进度更新。它们帮助开发者控制一次长任务的成本和交互节奏。技术更新说明
价格表以外,真正要算的账
目前只能引用已确认的价格。Fable 5.1 文档列出每百万 Token 输入 10 美元、输出 50 美元、缓存读取 0.25 美元;上下文为 100 万 Token,最大输出为 12.8 万 Token。Fable 5.5 是否延续这些数值,尚无官方确认。
输入价格与缓存读取价格的差距提醒我们,长任务的账单不只由模型名称决定。重复读取同一份资料、不断重写上下文、每次都从头解释目标,都会影响成本。衡量旗舰是否划算,更适合用这样一个编辑分析公式:
每个验收通过的任务成本 = 所有模型调用 + 工具与计算费用 + 失败重试 + 人工返工。
它没有承诺任何折扣。一个更贵的模型,若能消除多轮失败,可能降低总成本;一个更聪明但不停过度思考的模型,也可能让简单任务更慢。下一代 Fable 值不值得升级,取决于它在你的任务上落在哪种情况。
隐藏在模型之外的三件事
回退:你实际测到的可能是一套系统
RuBench 论文报告,在其 Fable 5 的额外测试配置中,25 个任务有 5 个发生了向 Opus 4.8 的安全回退。这个 7 月研究不能证明 10 月的灰度路由传闻;它说明,模型标签与完整执行链路需要分别记录。
因此测新模型时,既要看答案,也要看可用的返回字段、工具日志与回退配置。正式的模型标识规则参考模型 ID 与版本文档。
水印:内容来源不等于用户身份
Anthropic 的水印说明描述了统计文本水印:通过生成过程中的可替代选择留下概率模式,而非插入隐藏字符。它不承载特定用户身份;检测也受样本长度等因素限制。已有 Fable 5.1 的技术文档另说明了支持文件通过 Files API 取得时的 C2PA 内容凭证。两种机制不能混为一谈,也不宜据此猜测未公布的 5.5 行为。
能力与可部署性,需要一起提高
Anthropic 9 月的网络安全事件对齐评估分析了在错误联网的评测环境中发生的越界行为,并讨论监测、环境隔离和训练改进。这里讨论的是更广泛的前沿模型部署问题,不是已确认的 Fable 5.5 事故。
同样,Pacing the Frontier 声明提出建设协调前沿进展的技术与治理工具。这些材料提示了旗舰升级的一项现实条件:能力越能长时间自主执行,权限边界、证据记录和可中断性就越应该成为产品的一部分。它们没有给出某个模型的确定发布时间。
Fable 5.5 真正值得期待什么
综合这些独立检索的资料,我们会重点关注五个问题:困难任务上是否有可重复的优势;长任务能否持续保留目标;研究是否交付可检查产物;多模型协作是否减少总成本;公开评测是否说明工具、effort 与安全回退的条件。
这五点是本文的观察框架,而非产品规格。如果下一代 Fable 在这些地方取得进展,它的影响可能比一张更漂亮的截图更深:用户开始把完整的工作委托给系统,而不是不断用提示词修补每一个步骤。
目前最合理的做法,是把 Fable 5.5 看成一个值得持续核实的产品方向。等待官方型号、价格和可复查评测,同时用自己的困难任务建立基线。社区作品能帮助寻找灵感;决定一个旗舰是否有用的,最终是它能否稳定完成你关心的工作。
资料来源
本篇独立检索官方发布、技术文档、研究数据与原始评测。配图包括来源明确的研究图、据公开数据重绘的评测图,以及明确标注的编辑工作流示意。核查日期为 2026-10-03;没有对 Fable 5.5 作独立实测。
- Claude 模型目录与Anthropic 新闻页:公开产品与发布状态。
- Fable 5.1 发布材料:定位、研究与官方图像。
- Fable 5.1 规格与技术更新:API、价格和已知行为。
- Opus 5.5 发布介绍:本文厂商评测图的数据源。
- Snorkel 独立编程评测:原始测试与不同统计口径。
- Venus Opposite-Look Topography:金星地形公开数据记录。
- Fable 5 与模型编排专题:advisor 策略的历史背景。
- RuBench 论文:执行轨迹与模型回退观察。
- 文本水印说明与模型标识规则。
- 网络安全事件对齐评估与Pacing the Frontier:能力部署与研究背景。
- CellCog 的 Fable 5.5 传闻追踪:第三方线索,不作为规格或发布时间的确认。
查看社区案例库,或继续阅读Opus 5.5 专题与Jev 深度文章。